de
 en
 es
 fr
 nl
 it
 ar
Ausgangslage
Die Daten für die Führungsebene lagen in voneinander getrennten Systemen mit inkonsistenten Definitionen und wurden jeden Monat manuell abgeglichen.

Eine vertrauenswürdige Sicht auf Finanz-, Logistik- und kommerzielle Performance für die Führungsebene.
Cloud- und On-Premises-Datenbanken, formatierte Excel- und CSV-Dateien, harmonisiert über eine automatisierte Pipeline mit vom Fachbereich verantworteten Stammdaten und bereitgestellt in Power BI.
Ausgangslage
Die Daten für die Führungsebene lagen in voneinander getrennten Systemen mit inkonsistenten Definitionen und wurden jeden Monat manuell abgeglichen.
Umgesetzt
Ein maßgeschneidertes EIS-Dashboard auf einer automatisierten Pipeline: Staging, Aggregation, MDS-Anreicherung und DWH-Beladung.
Wirkung
Konsistente KPIs über Abteilungen hinweg, mit einem auditierbaren Aktualisierungsprotokoll.
Das Leadership Team von Alpro brauchte eine einzige, vertrauenswürdige Sicht auf die Unternehmensperformance – über Finanzergebnisse, Logistikbetrieb und kommerzielle Aktivitäten hinweg. Die zugrunde liegenden Daten lagen in voneinander getrennten Systemen mit inkonsistenten Definitionen: Cloud-Datenbanken, On-Premises-Datenbanken, manuell gepflegte Excel-Dateien mit aufwendiger Formatierung und CSV-Exporte. Eine stimmige Monatssicht für Entscheidungen der Führungsebene bedeutete manuellen Abgleich über Abteilungen hinweg – langsam, fehleranfällig und in jedem Zyklus aufs Neue teuer.
Wir haben ein maßgeschneidertes EIS-Dashboard konzipiert, das die wesentlichen KPIs in einer einzigen, intuitiven Oberfläche bündelt und visualisiert. Die Plattform nimmt Daten aus Cloud- und On-Premises-Datenbanken auf, verarbeitet formatierte Excel- und CSV-Dateien mit Python und harmonisiert alles über eine strukturierte Pipeline – Staging, Aggregation, Stammdatenanreicherung und DWH-Beladung –, bevor die Daten in Power BI bereitgestellt werden.
Die Pipeline ist durchgängig automatisiert. Die Daten fließen aus den Quellen über einen Python-Vorverarbeitungsschritt (Verarbeitung von Excel-Dateien mit nicht trivialer Formatierung, Konvertierung in CSV) in eine Linux-basierte Filter-Pipeline und dann in ein Staging-Schema zur Strukturnormalisierung. Aus dem Staging werden sie auf Monatsebene aggregiert, befüllen Zwischen-Faktentabellen und landen in MD-Data-Marts.
Über einen Master-Data-Service-Layer (MDS) reichern die Fachbereiche den Datenbestand mit Angaben an, die nur sie verantworten – Währungskurse, Einheiten, Umrechnungsfaktoren. Nach der Anreicherung läuft der Datenfluss automatisch weiter: Die Data Marts werden aus Faktentabellen und den MDS-Benutzerdaten berechnet und geladen; ein Ladeprotokoll erfasst jede Aktualisierung und alle Fehler samt Ursache. Die Power-BI-Datasets werden auf dieser vertrauenswürdigen Schicht aktualisiert.
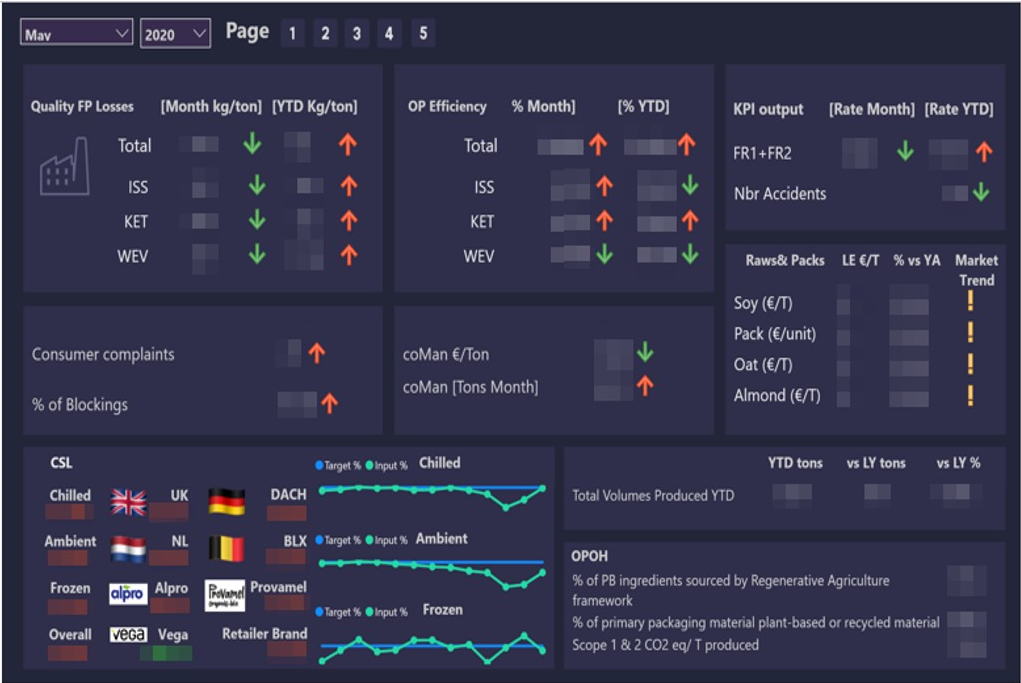
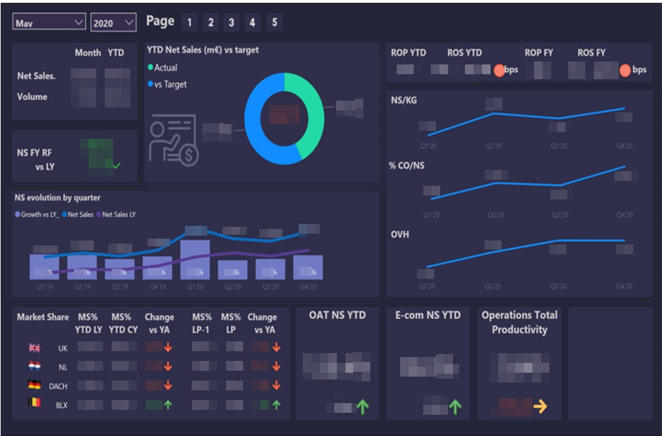
Zwei Screens aus dem Dashboard; die Zahlen sind unkenntlich gemacht.
Dashboard-Screen · 01 / 02
Nettoumsatz und Volumen, Nettoumsatz YTD gegenüber Ziel, Nettoumsatzentwicklung nach Quartal und Marktanteil nach Land.
Dashboard-Screen · 02 / 02
Qualitätsverluste, operative Effizienz, KPI-Output, Roh- und Packstoffkosten, Kundenservicegrad nach Kategorie und Nachhaltigkeitsindikatoren.
Qualitative Projektergebnisse; es werden keine gemessenen Einsparungen behauptet.
Eine vertrauenswürdige Sicht auf Finanz-, Logistik- und kommerzielle Performance für das Leadership Team
Echtzeit-Transparenz der Geschäftsentwicklung – eine kontrollierte Pipeline ersetzt den Abgleich per Tabellenkalkulation
Trends erkennen und proaktiv entscheiden statt rückblickend berichten
Datenkonsistenz über Abteilungen hinweg dank einer einzigen Harmonisierungsschicht
Vom Fachbereich verantwortete Stammdaten über MDS – Währungskurse, Einheiten und Umrechnungsfaktoren werden dort gepflegt, wo das Wissen liegt
Auditierbares Aktualisierungsprotokoll mit expliziten Fehlerursachen – für einen verlässlichen Monatsabschluss
Lösungsbereiche: Datenfundament · Datenprodukte

Wählen Sie ein 30-minütiges Gespräch oder senden Sie uns eine kurze Anfrage – ganz wie es Ihnen passt.