Kontakt

Datenfundament

Vertrauenswürdige, kontrollierte Daten für Reporting, Analytics und KI. Wir verbinden fragmentierte Quellen, etablieren wiederverwendbare Geschäftsobjekte und schaffen verlässliche Datenfundamente mit Qualitätskontrollen, Governance und klarer Ownership.

KI-fähiges Datenfundament

KI-Vorhaben sind auf Daten angewiesen, die konsistent, dokumentiert, kontrolliert und zugänglich sind. Wir etablieren die Qualitäts- und Ownership-Kontrollen, die auch Reporting und Analytics unterstützen.

KOMPETENZEN

Technische Grundlagen

  • Domänenmodell & Harmonisierung
  • Datenqualitätsregeln + Monitoring
  • Governance + Metadaten (Lineage, Katalog, Zugriff)
  • Sichere Integrationsmuster
LIEFERUMFANG

Greifbare Resultate

  • Datenschichten Bronze → Silver → Gold (Medallion)
  • Wiederverwendbare Geschäftsobjekte (Vertrieb, Finanzen, Produktion)
  • Datenqualitäts-Framework (Tests, Schwellenwerte, Behebung)
  • Katalog/Lineage + Zugriffsregeln
ERGEBNISSE

Geschäftsnutzen

  • Schnellere KPI-Bereitstellung (Entitäten wiederverwenden, weniger Ad-hoc-Logik)
  • Mehr Vertrauen (Quality Gates + Nachvollziehbarkeit)
  • Geringere Änderungskosten (neue Anwendungsfälle ohne Neuaufbau)
  • KI-fähige Datenprodukte (erklärbar, kontrolliert)

Von fragmentierten Quellen → konsistente Entitäten → KPI-fähige Data Marts → KI-fähige Features.

Von Quellsystemen zu entscheidungsreifen Daten

Wir überführen die Komplexität der Quellsysteme einmalig in wiederverwendbare Geschäftsobjekte – sodass jeder KPI und jeder KI-Anwendungsfall dieselbe vertrauenswürdige Logik nutzt.

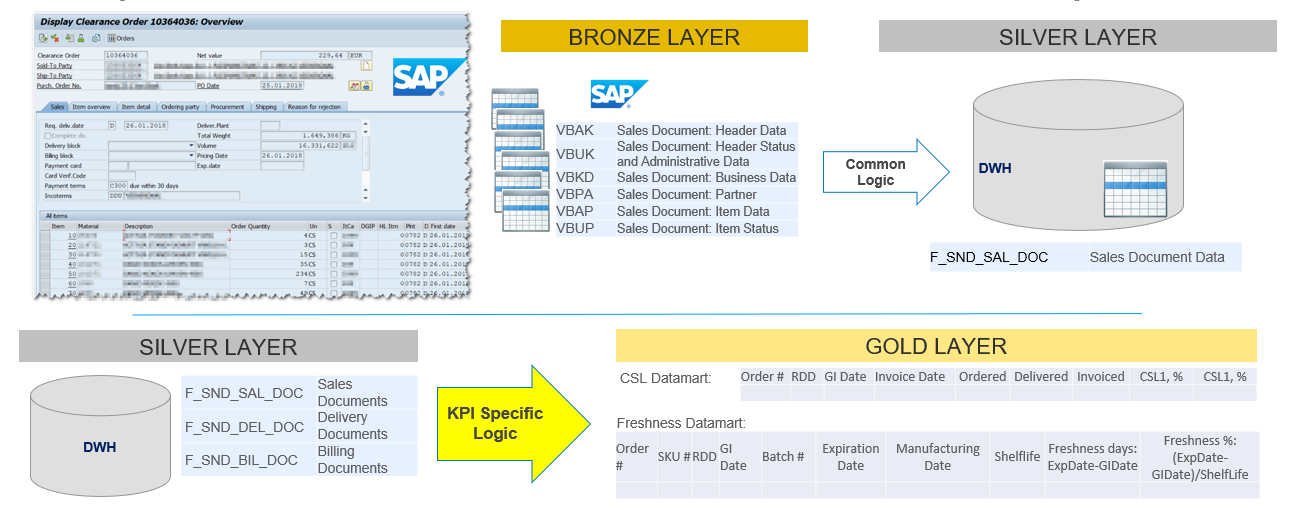
Quellsysteme halten Geschäftsdaten in Dutzenden oder Hunderten technischer Tabellen, und die KPI-Logik wird am Ende über Teams und Tools hinweg dupliziert. Wir reduzieren diese Komplexität auf ein Muster Bronze → Silver → Gold: Rohextrakte im Bronze-Layer, harmonisierte Geschäftsobjekte im Silver-Layer und KPI-fähige Data Marts im Gold-Layer.

Dasselbe Muster gilt, wann immer Sie eine neue Quelle anbinden – ein ERP, ein CRM, eine Marketingplattform, eine Individualanwendung. Jede neue Quelle fügt sich in dieselbe Datenfundament-Schicht ein, mit derselben Domänenstruktur, derselben Governance und denselben Qualitätskontrollen.

Transformation von SAP zum DWH: Extrakte im Bronze-Layer (VBAK, VBUK, VBKD, VBPA, VBAP, VBUP) fließen in das DWH im Silver-Layer (F_SND_SAL_DOC Sales Document Data), anschließend baut KPI-spezifische Logik den Gold-Layer auf (CSL Datamart, Freshness Datamart).
Beispiel: SAP-Quellsystem. Dasselbe Muster gilt für andere ERP- und CRM-Systeme, Marketingplattformen und Individualanwendungen. Zur Fallstudie „Aufbau eines SAP-basierten DWH“

Was das löst

  • SAP-Objekte über viele Tabellen verteilt → fehleranfällige Joins
  • Doppelte KPI-Logik in Teams und Tools
  • Datenqualitätsprobleme werden zu spät entdeckt (in Berichten)

Geschäftsergebnisse

  • Wiederverwendbare Silver-Entitäten (Vertriebsbelege, Lieferungen, Faktura …)
  • Stabile Logik + Performance (weniger Ad-hoc-Joins)
  • Governance + Qualitätskontrollen in die Pipelines integriert
  • Schnellere Anbindung neuer Anwendungsfälle und neuer Quellen

Bronze = Rohextrakte • Silver = harmonisierte Entitäten • Gold = KPI/Data Marts

Datendomänen

Wir strukturieren das DWH nach fachlichen Domänen, nicht nach technischen Tabellen.

Beispiel: SAP-Geschäftsobjekte und ihre Kerntabellen. Derselbe Domänenansatz gilt für jedes Quellsystem.

GeschäftsobjektBeispiel: SAP-Tabellen
VertriebsbelegeVBAK, VBAP, VBEP, VBKD
LieferungenLIKP, LIPS, VTTK, VTTS
FakturaVBRK, VBRP, BSEG
MaterialienMARA, MARC, MARD, MBEW
KundenKNA1, KNVV, KNVP
LieferantenLFA1, LFB1, LFM1
BestellungenEKKO, EKPO, EKET
FertigungsaufträgeAUFK, AFKO, AFPO

Domänenansatz

  • Eine Domäne nach der anderen aufbauen (Vertrieb, Finanzen, Einkauf, Produktion …)
  • Jede Domäne liefert: Entitätenmodell + Qualitätsregeln + Governance
  • Domänen ergeben zusammen funktionsübergreifende Analytics und KI

Warum es zählt

  • Klare Ownership und Stewardship je Domäne
  • Nutzbar für Reporting, Planung, Automation
  • Schnellere Umsetzung, ohne bestehende Logik zu beschädigen

DataOps & Plattformstabilität

Eine Datenplattform ist ein lebendes Produkt – Änderungen müssen sicher, testbar und auditierbar sein.

Kontrollierte Releases

  • CI/CD-Pipelines, Freigaben, Versionierung
  • Rollback-Strategie und identische Umgebungen (Dev / Test / Prod)

Quality Gates

  • Automatisierte Tests (Unit + Daten)
  • Abgleichsprüfungen und SLA-Monitoring

Operative Transparenz

  • Monitoring, Alerting, Incident-Playbooks
  • Lineage und Nachvollziehbarkeit von Änderungen (wer hat was wann und warum geändert)

Legacy-ETL & Datenplattformen modernisieren

Kosten und Komplexität senken und zugleich Governance, Skalierbarkeit und Änderungsgeschwindigkeit verbessern.

Herausforderungen

  • Zu viele ETL-Tools und fragmentierte Workflows
  • Hohe Lizenz- + Infrastrukturkosten
  • Wenig Governance und Transparenz
  • Analytics und KI schwer konsistent skalierbar

Unser Ansatz

  • Pipelines auf einer kontrollierten Plattform konsolidieren (Cloud oder Hybrid)
  • Muster standardisieren (Namensgebung, Sicherheit, Monitoring, Tests)
  • Umsetzung industrialisieren mit DataOps + wiederverwendbaren Domänenmodellen

Kernergebnisse

  • Geringere Betriebskosten, weniger Einzelteile
  • Ein Umsetzungsansatz (Skills + Templates)
  • Bessere Governance, Observability und Zuverlässigkeit
  • Zukunftssicheres Fundament für Analytics und KI

Cloud, Integration & Echtzeit

Moderne Integrationsmuster und operative Transparenz – in Cloud-, Hybrid- und On-Prem-Umgebungen.

Cloud- & Datenintegration

  • Cloud-Migrationen
  • API-first-Pipelines
  • Hybrid- & Multi-Cloud-Umsetzung
  • Integration mit ERP, CRM und operativen Systemen

Echtzeitdaten & Observability

  • Streaming + operative Transparenz (Grafana-fähig)
  • Alerts und Live-KPIs
  • Ereignisgesteuerte Architekturen (Kafka, Message Broker)
  • Datenfluss von der Edge in die Cloud für industrielle Anwendungsfälle

Arbeitsweise

Drei Prinzipien leiten jedes Datenfundament-Projekt: Ergebnis vor Tool, kein Vendor-Lock-in und Ownership im Fachbereich.

Ergebnis vor Tool

  • Ausgangspunkt: geschäftliche Schmerzpunkte und die Entscheidungen, die Sie verbessern möchten
  • Erfolgskennzahlen festlegen (Durchlaufzeit, Prognosegenauigkeit, Servicegrad, Kosten)
  • Architektur wählen, die zu Ihrer bestehenden Landschaft passt (SAP, Legacy, Cloud)

Kein Vendor-Lock-in

  • Portable Muster: codebasierte Pipelines, modulare Architektur
  • Toolunabhängige Umsetzung (Azure / GCP / AWS / On-Prem)
  • Sie behalten die Kontrolle: Dokumentation, Ownership, saubere Übergabe

Ownership im Fachbereich

  • Klare Data Ownership (Fachbereich + IT) und Stewardship-Modell
  • Change Management: Nutzerakzeptanz, Schulung, Governance-Routinen
  • Der „Go-live“ ist nicht das Ende – wir etablieren ein gelebtes Betriebsmodell

Fundament statt Feature gesucht?

Wenn Integration, Datenqualität oder unklare Ownership Reporting, Analytics oder KI ausbremsen, helfen wir, das Fundament für eine verlässliche Umsetzung zu schaffen. Bringen Sie ein priorisiertes Vorhaben in ein 30-minütiges Gespräch mit – wir besprechen Ihre aktuelle Landschaft und einen praktikablen Einstieg.

30-Minuten-Gespräch buchen