contactez-nous

Fondations de données

Des données fiables et gouvernées pour le reporting, l'analytique et l'IA. Nous relions des sources fragmentées, établissons des entités métier réutilisables et construisons des fondations de données fiables, avec des contrôles qualité, une gouvernance et des responsabilités claires.

Fondations prêtes pour l'IA

Les initiatives d'IA reposent sur des données cohérentes, documentées, gouvernées et accessibles. Nous mettons en place les contrôles de qualité et de responsabilité qui servent aussi le reporting et l'analytique.

EXPERTISES

Fondations techniques

  • Modèles de domaine et harmonisation
  • Règles de qualité data + suivi
  • Gouvernance + métadonnées (lignage, catalogue, accès)
  • Modèles d'intégration sécurisés
LIVRABLES

Résultats concrets

  • Couches de données Bronze → Silver → Gold (médaillon)
  • Entités métier réutilisables (ventes, finance, production)
  • Cadre de qualité des données (tests, seuils, remédiation)
  • Catalogue/lignage + règles d'accès
BÉNÉFICES

Valeur métier

  • Des KPI livrés plus vite (entités réutilisées, moins de logique ad hoc)
  • Plus de confiance (points de contrôle qualité + traçabilité)
  • Un coût du changement réduit (les nouveaux cas d'usage ne repartent pas de zéro)
  • Des produits de données prêts pour l'IA (explicables, gouvernés)

Des sources fragmentées → entités cohérentes → datamarts prêts pour les KPI → variables prêtes pour l'IA.

Des systèmes sources aux données décisionnelles

Nous ramenons une fois pour toutes la complexité des systèmes sources à des entités métier réutilisables, afin que chaque KPI et chaque cas d'usage IA s'appuie sur la même logique fiable.

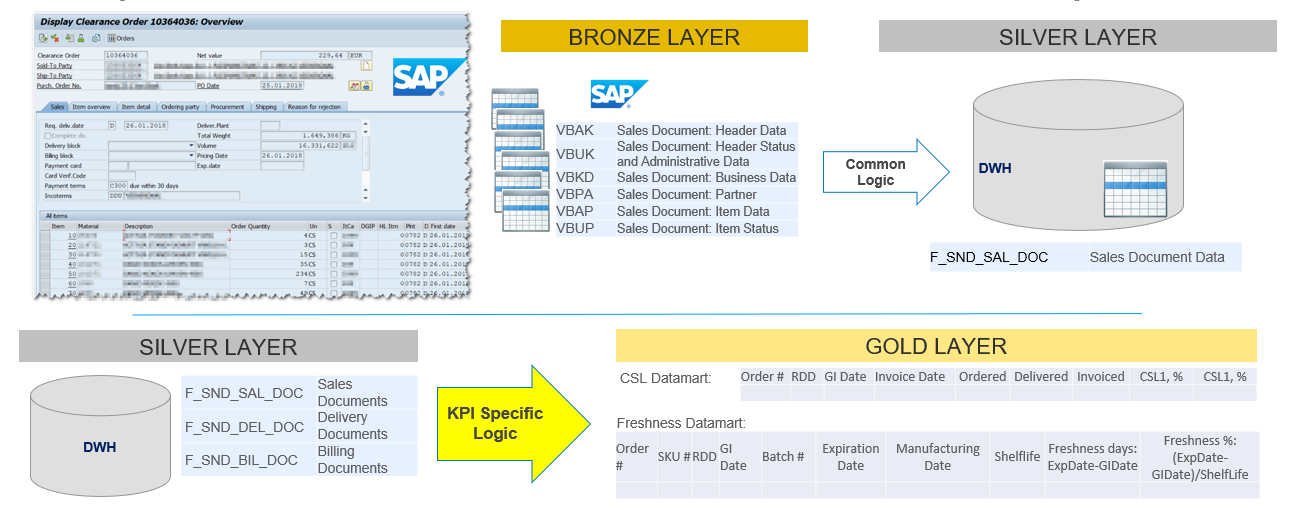
Les systèmes sources stockent les données métier dans des dizaines, voire des centaines de tables techniques, et la logique des KPI finit dupliquée entre équipes et outils. Nous ramenons cette complexité à un modèle Bronze → Silver → Gold : extractions brutes dans la couche Bronze, entités métier harmonisées dans la couche Silver et datamarts prêts pour les KPI dans la couche Gold.

Le même modèle s'applique chaque fois que vous intégrez une nouvelle source : un ERP, un CRM, une plateforme marketing, une application sur mesure. Chaque nouvelle source se branche sur la même couche de fondations de données, avec la même structure par domaine, la même gouvernance et les mêmes contrôles qualité.

Transformation de SAP vers le DWH : les extractions de la couche Bronze (VBAK, VBUK, VBKD, VBPA, VBAP, VBUP) alimentent le DWH de la couche Silver (F_SND_SAL_DOC Sales Document Data), puis une logique propre à chaque KPI construit la couche Gold (CSL Datamart, Freshness Datamart).
Exemple : système source SAP. Le même modèle s'applique aux autres ERP, CRM, plateformes marketing et applications sur mesure. Voir l'étude de cas Entrepôt de données alimenté par SAP

Ce que cela résout

  • Objets SAP répartis sur de nombreuses tables → jointures sources d'erreurs
  • Logique KPI dupliquée entre équipes et outils
  • Problèmes de qualité des données découverts trop tard (dans les rapports)

Résultats métier

  • Entités Silver réutilisables (documents de vente, livraisons, facturation…)
  • Logique stable + performance (moins de jointures ad hoc)
  • Gouvernance + contrôles qualité intégrés aux pipelines
  • Intégration plus rapide de nouveaux cas d'usage et de nouvelles sources

Bronze = extractions brutes • Silver = entités harmonisées • Gold = KPI/datamarts

Domaines data

Nous structurons le DWH par domaines métier, et non par tables techniques.

Exemple : les entités métier SAP et leurs tables principales. La même approche par domaine s'applique à tout système source.

Entité métierExemple : tables SAP
Documents de venteVBAK, VBAP, VBEP, VBKD
LivraisonsLIKP, LIPS, VTTK, VTTS
FacturesVBRK, VBRP, BSEG
ArticlesMARA, MARC, MARD, MBEW
ClientsKNA1, KNVV, KNVP
FournisseursLFA1, LFB1, LFM1
Commandes d'achatEKKO, EKPO, EKET
Ordres de fabricationAUFK, AFKO, AFPO

Approche domaine

  • Construire un domaine à la fois (ventes, finance, achats, production…)
  • Chaque domaine livre : modèle d'entités + règles de qualité + gouvernance
  • Les domaines se combinent pour une analytique et une IA transverses

Les bénéfices

  • Responsables et stewards clairs par domaine
  • Réemploi : reporting, planification, automatisation
  • Des livraisons plus rapides sans casser la logique existante

DataOps et fiabilité plateforme

Une plateforme de données est un produit vivant : les changements doivent être sûrs, testables et auditables.

Livraisons maîtrisées

  • Pipelines CI/CD, validations, versionnage
  • Stratégie de retour arrière et parité des environnements (dev / test / prod)

Points de contrôle qualité

  • Tests automatisés (unitaires + data)
  • Rapprochements et suivi des SLA

Visibilité opérationnelle

  • Supervision, alertes, playbooks d'incident
  • Lignage et traçabilité des changements (qui a modifié quoi, quand, pourquoi)

Moderniser ETL et plateformes historiques

Réduisez les coûts et la complexité tout en améliorant la gouvernance, l'évolutivité et les délais de changement.

Défis des clients

  • Trop d'outils ETL et des flux fragmentés
  • Licences + infrastructure coûteuses
  • Gouvernance et visibilité limitées
  • Analytique et IA difficiles à généraliser

Notre approche

  • Consolider les pipelines sur une plateforme gouvernée (cloud ou hybride)
  • Standardiser les modèles (nommage, sécurité, supervision, tests)
  • Industrialiser la réalisation avec DataOps + modèles de domaine réutilisables

Résultats clés

  • Exploitation moins chère et plus simple
  • Une seule approche (savoir-faire + modèles)
  • Gouvernance, observabilité et fiabilité améliorées
  • Un socle pérenne pour l'analytique et l'IA

Cloud, intégration et temps réel

Des modèles d'intégration modernes et une visibilité opérationnelle, en cloud, en hybride et sur site.

Cloud et intégration data

  • Migrations cloud
  • Pipelines API-first
  • Projets hybrides et multicloud
  • Intégration avec les ERP, CRM et systèmes opérationnels

Données temps réel et observabilité

  • Streaming + visibilité opérationnelle (compatible Grafana)
  • Alertes, KPI en direct
  • Architectures événementielles (Kafka, brokers de messages)
  • Flux de données de l'edge au cloud pour les cas d'usage industriels

Notre façon de travailler

Trois principes guident chaque mission Fondations de données : le résultat avant l'outil, aucune dépendance éditeur et un métier impliqué d'emblée.

Le résultat avant l'outil

  • Partir des difficultés métier et des décisions que vous souhaitez améliorer
  • Définir des indicateurs de réussite (temps de cycle, précision des prévisions, niveau de service, coût)
  • Choisir une architecture adaptée à votre existant (SAP, systèmes historiques, cloud)

Sans dépendance éditeur

  • Modèles portables : pipelines as code, architecture modulaire
  • Indépendants des outils (Azure / GCP / AWS / on-prem)
  • Vous gardez la main : documentation, propriété, passation

Le métier impliqué d'emblée

  • Responsabilités claires sur les données (métier + IT) et modèle de stewardship
  • Conduite du changement : adoption, formation, gouvernance
  • Le go-live n'est pas la fin : un modèle opérationnel vivant

Un socle, pas une fonctionnalité ?

Lorsque l'intégration, la qualité des données ou des responsabilités floues bloquent le reporting, l'analytique ou l'IA, nous vous aidons à poser les fondations d'une réalisation fiable. Venez avec une initiative prioritaire pour un échange de 30 minutes : nous passerons en revue votre existant et un point de départ concret.

Réservez un échange de 30 min