nl
 en
 es
 fr
 it
 de
 ar
Uitdaging
Hetzelfde fysieke materiaal, vastgelegd onder verschillende codes en omschrijvingen in fabrieken, regio's en dochterondernemingen.

Vind dubbele en bijna-dubbele materialen over fabrieken en ERP-systemen heen.
Een AI-ondersteunde similarity-engine clustert op elkaar lijkende materialen, kwantificeert de consolidatiebesparingen per cluster en geeft data stewards een reviewworkflow.
Uitdaging
Hetzelfde fysieke materiaal, vastgelegd onder verschillende codes en omschrijvingen in fabrieken, regio's en dochterondernemingen.
Opgeleverd
Een similarity-engine op basis van omschrijvingen, attributen en inkooppatronen, plus een reviewworkflow voor stewards.
Beslisondersteuning
Elk cluster krijgt een businesscase voor consolidatie: behouden, blokkeren of laten vervallen.
Wereldwijde fabrikanten hebben honderdduizenden materialen in hun ERP-systemen, waarbij hetzelfde fysieke materiaal onder verschillende codes, namen en omschrijvingen is vastgelegd in fabrieken, regio's en overgenomen dochterondernemingen. Het gevolg: gemiste volumekortingen, te hoge voorraden, maverick buying en inkoopuitgaven die niet te consolideren zijn. Iedereen weet dat stamgegevens opgeschoond moeten worden en iedereen schuift het voor zich uit - totdat de kosten van niets doen oplopen.
We bouwden een AI-ondersteunde similarity-engine die dubbele en bijna-dubbele materialen over fabrieken en ERP-systemen heen opspoort. De engine gebruikt materiaalomschrijvingen, attributen en inkooppatronen om op elkaar lijkende materialen te clusteren en kwantificeert vervolgens de consolidatiebesparingen per cluster - op basis van werkelijke inkoopvolumes en kortingscurves van leveranciers.
Met een stewardworkflow beoordelen datamanagers elk cluster en beslissen ze: behouden, blokkeren of laten vervallen. Achter elke opschoonactie zit een businesscase.
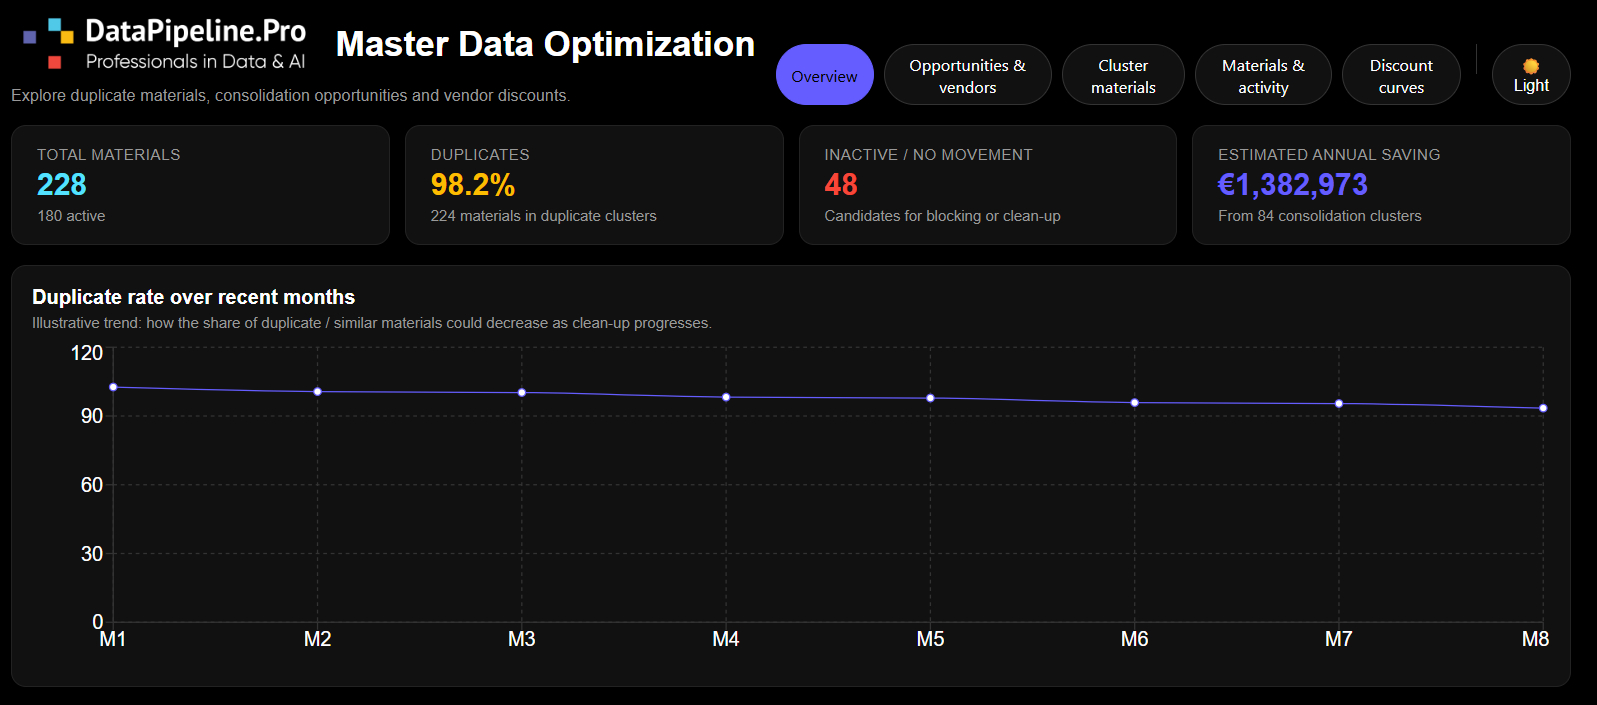
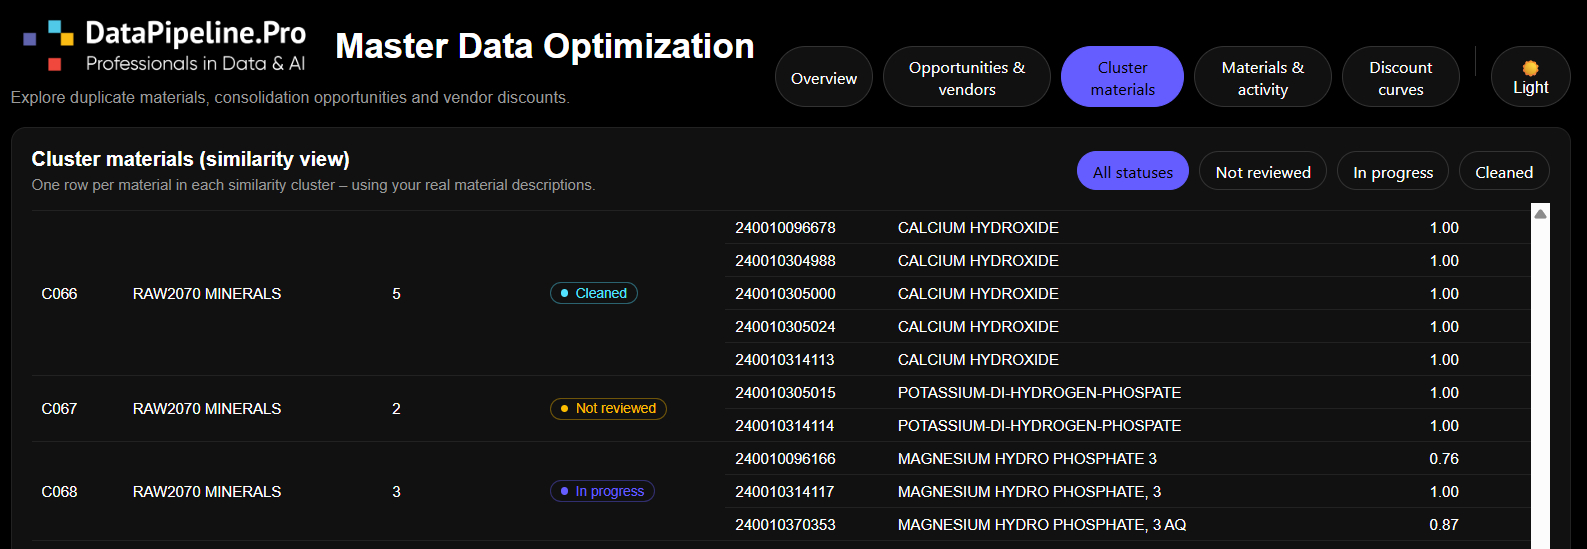
Twee schermen uit de losstaande demoversie van de opdracht; de cijfers zijn illustratief.
Demoscherm · 01 / 02
Eén rij per materiaal in elk gelijkeniscluster, met materiaalcode, omschrijving, gelijkenisscore en de reviewstatus van het cluster.
Demoscherm · 02 / 02
Totaal aantal materialen, aandeel duplicaten, inactieve materialen en geschatte jaarlijkse besparing, met een illustratieve trend van het duplicaatpercentage.
De cijfers komen uit de demoset (zie de opmerking hieronder), niet van de klantlocatie.
228 materialen geanalyseerd in de demoset, waarvan 98,2% in duplicaatclusters is aangetroffen
48 kandidaten gemarkeerd voor blokkeren of opschonen
€ 1.382.973 geschatte jaarlijkse besparing uit 84 consolidatieclusters (illustratief)
Sneller opschonen met een businesscase achter elke wijziging
Minder overvoorraad, minder gemiste kortingen, minder maverick buying
Eén betrouwbaar beeld van materialen, als steun voor betere sourcing- en operationele beslissingen
De getoonde cijfers zijn illustratief - afgeleid van een losstaande demoversie van de opdracht, gebouwd op synthetische data. De werkelijke resultaten bij de klant vallen onder NDA.
Oplossingsgebieden: Datafundament · Dataproducten · AI-oplossingen

Kies voor een gesprek van 30 minuten of stuur ons een korte aanvraag - wat u het beste past.