fr
 en
 es
 nl
 it
 de
 ar
Défi
Un même article physique enregistré sous des codes et des descriptions différents selon les sites, les régions et les filiales.

Repérez les articles en double ou quasi identiques entre sites et ERP.
Un moteur de similarité assisté par IA regroupe les articles qui se ressemblent, chiffre les économies de consolidation par cluster et offre aux data stewards un circuit de revue.
Défi
Un même article physique enregistré sous des codes et des descriptions différents selon les sites, les régions et les filiales.
Livré
Un moteur de similarité fondé sur les descriptions, les attributs et les habitudes d'achat, complété par un circuit de revue par les data stewards.
Aide à la décision
Chaque cluster s'accompagne d'un business case de consolidation : conserver, bloquer ou rendre obsolète.
Les industriels mondiaux gèrent des centaines de milliers d'articles dans leurs ERP, un même article physique étant enregistré sous des codes, des noms et des descriptions différents selon les sites, les régions et les filiales acquises. Conséquences : des remises sur volume manquées, du surstockage, des achats hors contrat et l'impossibilité de consolider les dépenses d'achats. Chacun sait que le nettoyage des données de référence est nécessaire, et chacun le remet à plus tard, jusqu'à ce que le coût de l'inaction s'accumule.
Nous avons construit un moteur de similarité assisté par IA qui détecte les articles en double ou quasi identiques entre sites et ERP. Le moteur s'appuie sur les descriptions des articles, leurs attributs et les habitudes d'achat pour regrouper les articles qui se ressemblent, puis chiffre les économies de consolidation par cluster, à partir des volumes d'achat réels et des barèmes de remise des fournisseurs.
Un circuit de revue permet aux gestionnaires de données d'examiner chaque cluster et de décider : conserver, bloquer ou rendre obsolète. Chaque action de nettoyage s'appuie sur un business case.
Deux écrans de la version de démonstration autonome de la mission ; les chiffres sont illustratifs.
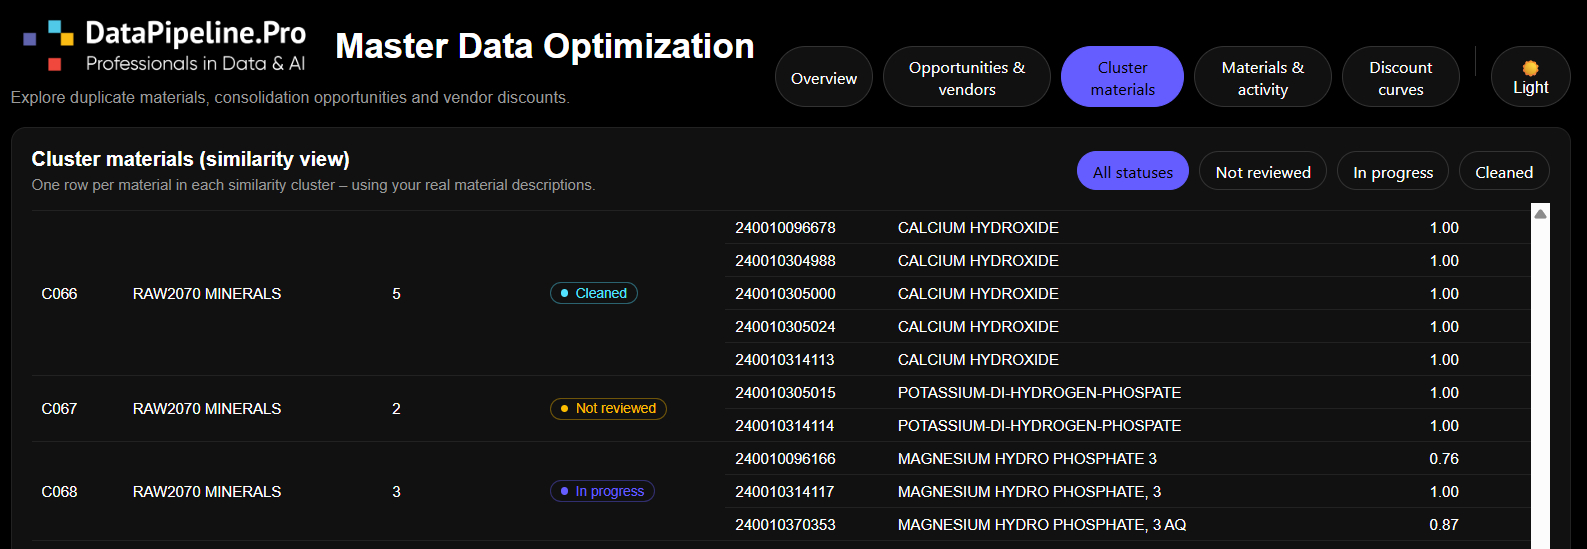
Écran de démo · 01 / 02
Une ligne par article dans chaque cluster de similarité, avec le code article, la description, le score de similarité et le statut de revue du cluster.
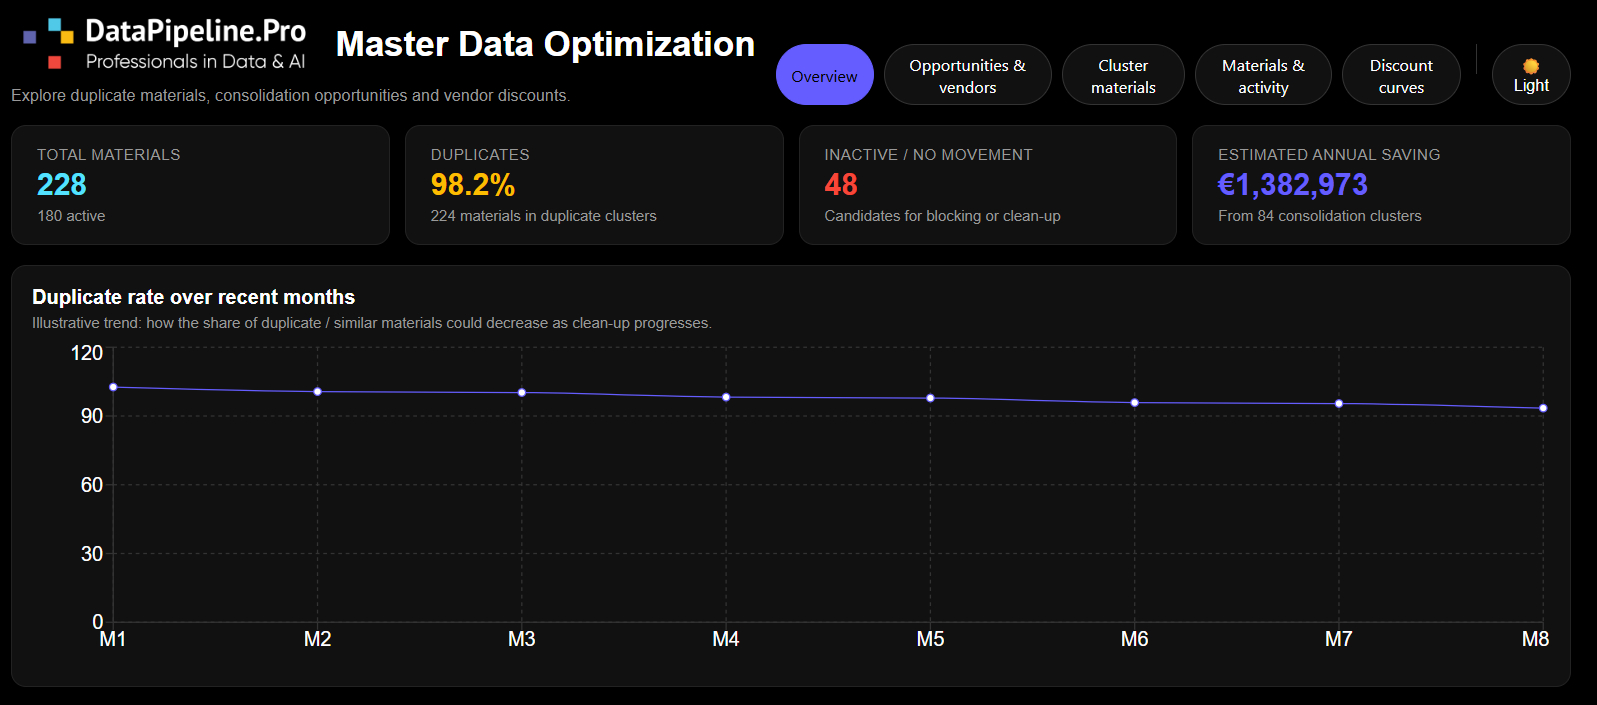
Écran de démo · 02 / 02
Nombre total d'articles, part de doublons, articles inactifs et économie annuelle estimée, avec une tendance illustrative du taux de doublons.
Les chiffres proviennent du jeu de démonstration (voir la note ci-dessous), et non du site du client.
228 articles analysés dans le jeu de démonstration, dont 98,2 % identifiés comme appartenant à des clusters de doublons
48 candidats signalés pour blocage ou nettoyage
1 382 973 € d'économie annuelle estimée sur 84 clusters de consolidation (illustratif)
Un nettoyage plus rapide, avec un business case derrière chaque changement
Moins de surstockage, moins de remises manquées, moins d'achats hors contrat
Une vue fiable et unique des articles, au service de meilleures décisions d'approvisionnement et d'exploitation
Les chiffres présentés sont illustratifs : ils proviennent d'une version de démonstration autonome de la mission, construite sur des données synthétiques. Les résultats réels chez le client sont protégés par un NDA.
Solutions : Fondations de données · Produits de données · Solutions d'IA

Choisissez un échange de 30 minutes ou envoyez-nous une courte demande, selon ce qui vous convient.