 it
 en
 es
 fr
 nl
 de
 ar
Sfida
Lo stesso materiale fisico registrato con codici e descrizioni diversi tra stabilimenti, regioni e filiali.

Individuate i materiali duplicati e quasi duplicati tra stabilimenti ed ERP.
Un motore di similarità assistito dall'IA raggruppa in cluster i materiali simili, quantifica i risparmi di consolidamento per cluster e offre ai data steward un flusso di revisione.
Sfida
Lo stesso materiale fisico registrato con codici e descrizioni diversi tra stabilimenti, regioni e filiali.
Realizzato
Un motore di similarità che usa descrizioni, attributi e pattern di acquisto, più un flusso di revisione per i data steward.
Supporto decisionale
Ogni cluster è accompagnato da un business case di consolidamento: mantenere, bloccare o rendere obsoleto.
I produttori globali gestiscono nei propri ERP centinaia di migliaia di materiali, con lo stesso materiale fisico registrato con codici, nomi e descrizioni diversi tra stabilimenti, regioni e filiali acquisite. Il risultato: sconti a volume mancati, scorte in eccesso, acquisti fuori contratto (maverick spending) e l'impossibilità di consolidare la spesa di acquisto. La pulizia dei dati anagrafici (master data) è riconosciuta da tutti come necessaria e da tutti rimandata, finché il costo dell'inazione non si accumula.
Abbiamo costruito un motore di similarità assistito dall'IA che rileva materiali duplicati e quasi duplicati tra stabilimenti ed ERP. Il motore usa descrizioni dei materiali, attributi e pattern di acquisto per raggruppare in cluster i materiali simili, poi quantifica i risparmi di consolidamento per cluster, sulla base dei volumi di acquisto reali e delle curve di sconto dei fornitori.
Un flusso di lavoro per i data steward consente ai responsabili dei dati di esaminare ogni cluster e decidere: mantenere, bloccare o rendere obsoleto. Ogni azione di pulizia ha alle spalle un business case.
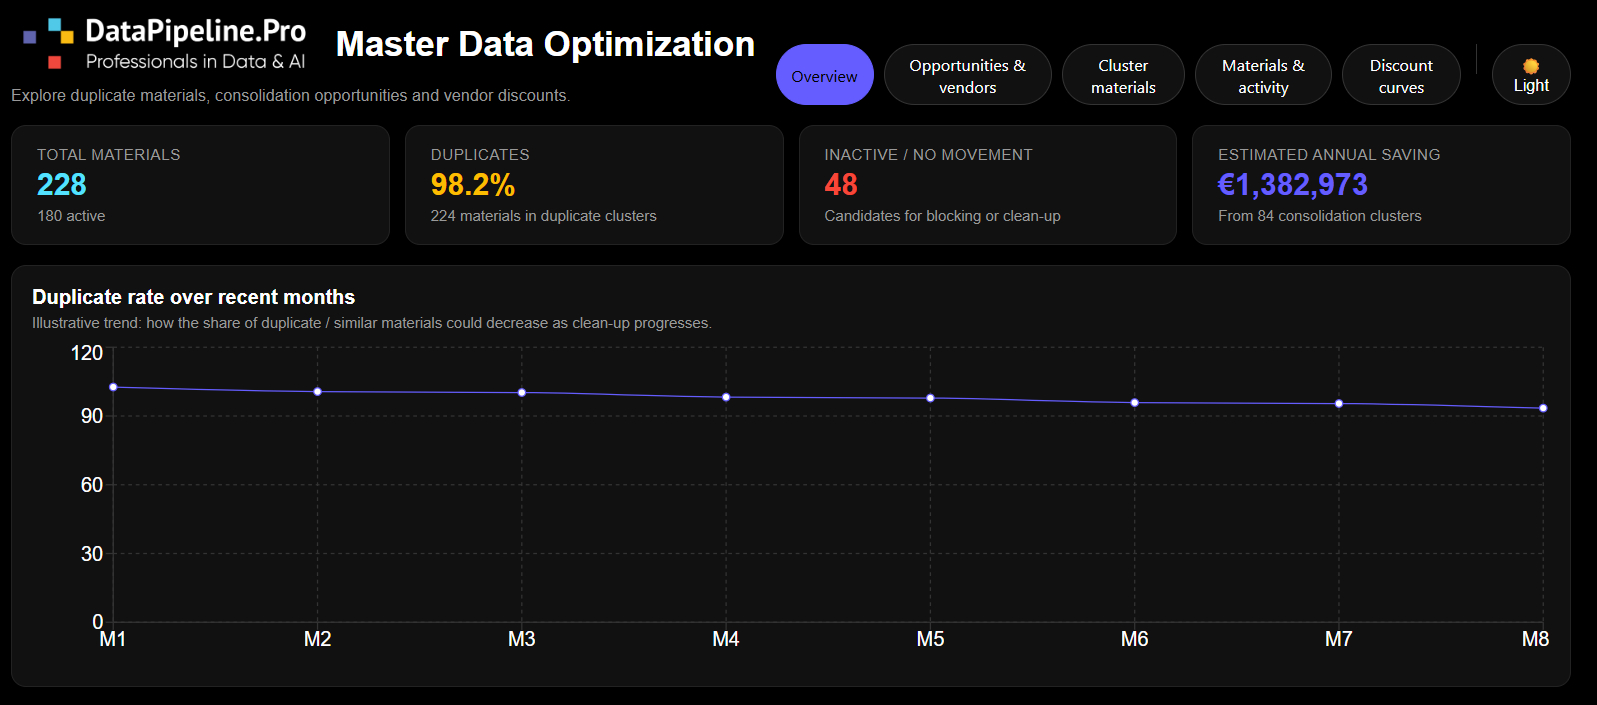
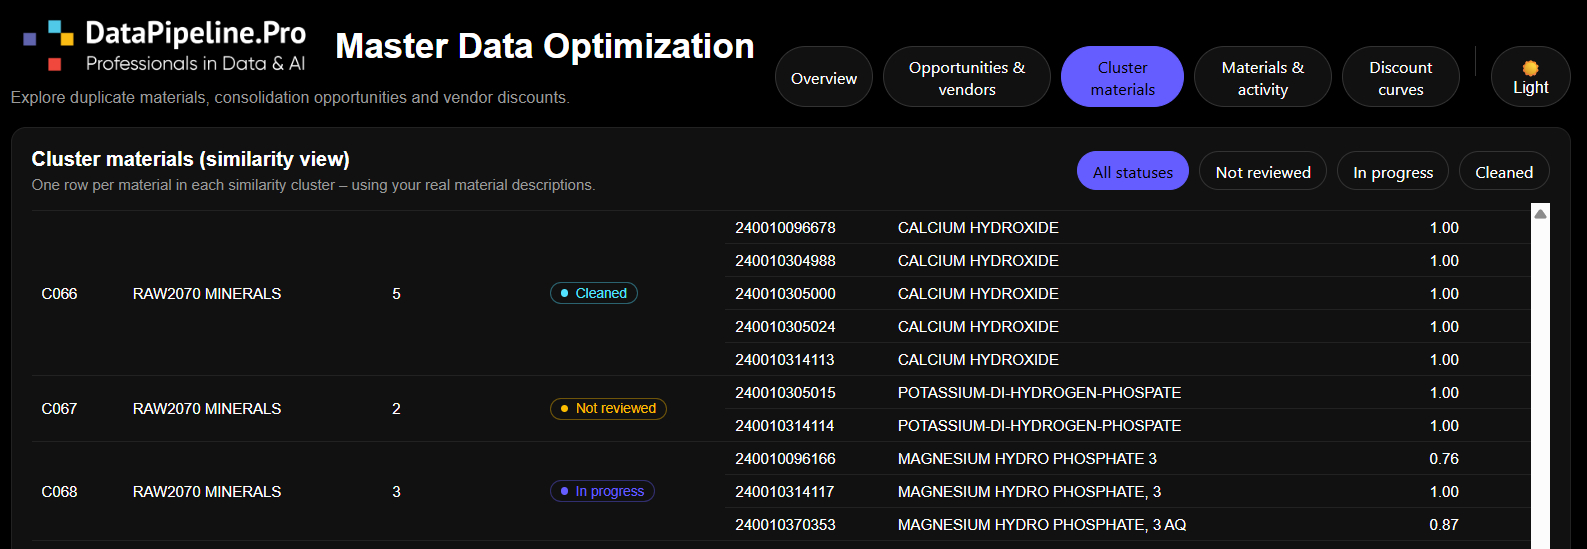
Due schermate della versione demo autonoma del progetto; le cifre sono illustrative.
Schermata demo · 01 / 02
Una riga per materiale in ogni cluster di similarità, con codice materiale, descrizione, punteggio di similarità e stato di revisione del cluster.
Schermata demo · 02 / 02
Materiali totali, quota di duplicati, materiali inattivi e risparmio annuo stimato, con un trend illustrativo del tasso di duplicati.
Le cifre provengono dal set demo (vedi la nota qui sotto), non dall'ambiente del cliente.
228 materiali analizzati nel set demo, di cui il 98,2% individuato in cluster di duplicati
48 candidati segnalati per il blocco o la pulizia
1.382.973 € di risparmio annuo stimato da 84 cluster di consolidamento (dato illustrativo)
Pulizia più rapida, con un business case dietro ogni modifica
Meno scorte in eccesso, meno sconti mancati, meno acquisti fuori contratto
Un'unica vista affidabile dei materiali a supporto di decisioni di sourcing e operative migliori
Le cifre mostrate sono illustrative: derivano da una versione demo autonoma del progetto costruita su dati sintetici. I risultati effettivi presso il cliente sono protetti da NDA.
Aree di soluzione: Fondamenta dei dati · Prodotti dati · Soluzioni IA

Scegliete una conversazione di 30 minuti o inviateci una breve richiesta: come preferite.