de
 en
 es
 fr
 nl
 it
 ar
Ausgangslage
Dasselbe physische Material, erfasst unter verschiedenen Nummern und Beschreibungen in Werken, Regionen und Tochtergesellschaften.

Doppelte und nahezu doppelte Materialien über Werke und ERP-Systeme hinweg finden.
Eine KI-gestützte Ähnlichkeits-Engine clustert ähnlich aussehende Materialien, beziffert die Konsolidierungseinsparungen je Cluster und gibt Data Stewards einen Review-Workflow an die Hand.
Ausgangslage
Dasselbe physische Material, erfasst unter verschiedenen Nummern und Beschreibungen in Werken, Regionen und Tochtergesellschaften.
Umgesetzt
Eine Ähnlichkeits-Engine auf Basis von Beschreibungen, Attributen und Einkaufsmustern sowie ein Review-Workflow für Data Stewards.
Entscheidungshilfe
Zu jedem Cluster gibt es einen Business Case für die Konsolidierung: behalten, sperren oder obsolet.
Globale Hersteller führen Hunderttausende Materialien in ihren ERP-Systemen – dasselbe physische Material ist in Werken, Regionen und zugekauften Tochtergesellschaften unter verschiedenen Nummern, Namen und Beschreibungen erfasst. Die Folge: entgangene Mengenrabatte, Überbestände, Maverick Buying und die Unfähigkeit, das Einkaufsvolumen zu bündeln. Dass Stammdaten bereinigt werden müssen, weiß jeder – und jeder stellt es zurück, bis sich die Kosten des Nichtstuns summieren.
Wir haben eine KI-gestützte Ähnlichkeits-Engine gebaut, die doppelte und nahezu doppelte Materialien über Werke und ERP-Systeme hinweg erkennt. Die Engine nutzt Materialbeschreibungen, Attribute und Einkaufsmuster, um ähnlich aussehende Materialien zu clustern, und beziffert dann die Konsolidierungseinsparungen je Cluster – auf Basis realer Einkaufsvolumina und der Rabattstaffeln der Lieferanten.
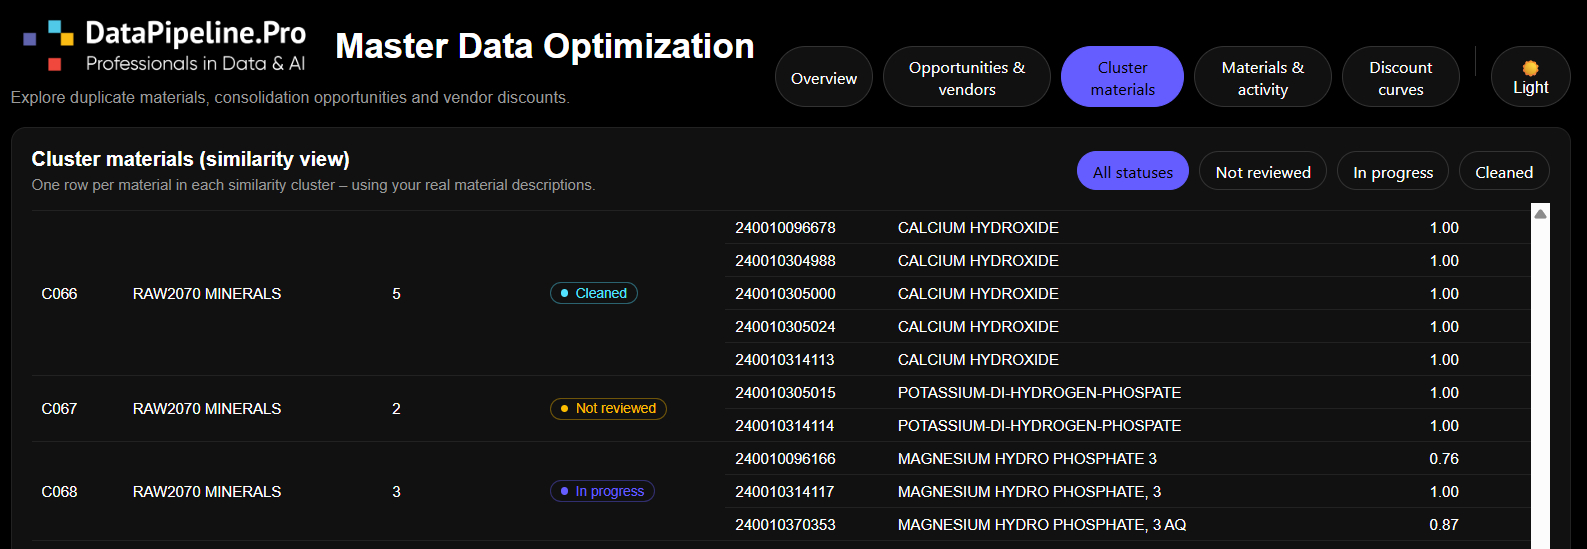
In einem Steward-Workflow prüfen die Datenverantwortlichen jedes Cluster und entscheiden: behalten, sperren oder obsolet. Hinter jeder Bereinigungsmaßnahme steht ein Business Case.
Zwei Screens aus der eigenständigen Demoversion des Projekts; die Zahlen sind illustrativ.
Demo-Screen · 01 / 02
Eine Zeile je Material in jedem Ähnlichkeitscluster, mit Materialnummer, Beschreibung, Ähnlichkeitswert und dem Prüfstatus des Clusters.
Demo-Screen · 02 / 02
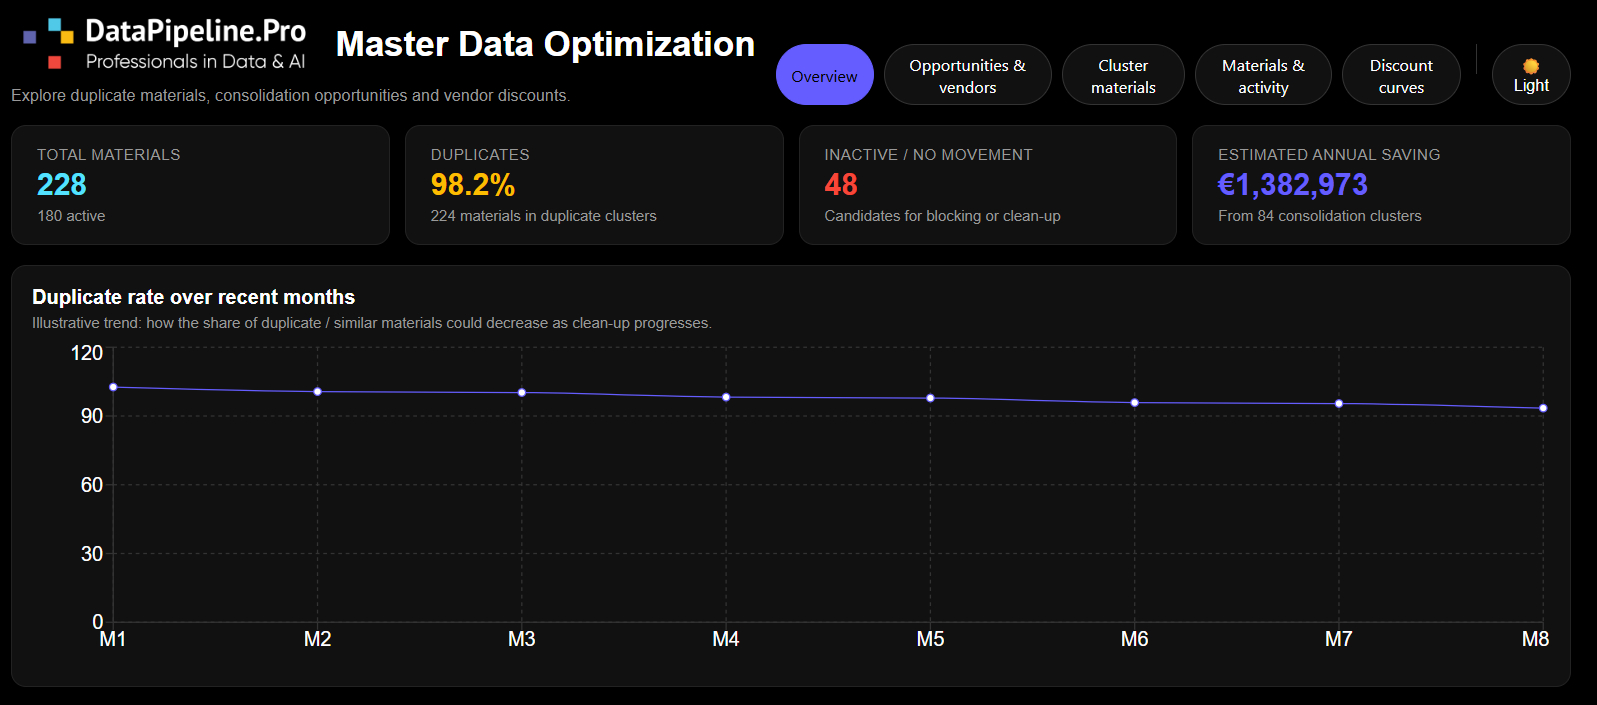
Materialien gesamt, Duplikatanteil, inaktive Materialien und geschätzte jährliche Einsparung, mit einem illustrativen Trend der Duplikatquote.
Die Zahlen stammen aus dem Demo-Datensatz (siehe Hinweis unten), nicht vom Kundenstandort.
228 Materialien im Demo-Datensatz analysiert, davon 98,2 % in Duplikat-Clustern
48 Kandidaten für Sperrung oder Bereinigung markiert
1.382.973 € geschätzte jährliche Einsparung aus 84 Konsolidierungsclustern (illustrativ)
Schnellere Bereinigung mit einem Business Case hinter jeder Änderung
Weniger Überbestände, weniger entgangene Rabatte, weniger Maverick Buying
Eine vertrauenswürdige Materialsicht für bessere Beschaffungs- und operative Entscheidungen
Die gezeigten Zahlen sind illustrativ – sie stammen aus einer eigenständigen Demoversion des Projekts auf Basis synthetischer Daten. Die tatsächlichen Ergebnisse beim Kunden unterliegen einem NDA.
Lösungsbereiche: Datenfundament · Datenprodukte · KI-Lösungen

Wählen Sie ein 30-minütiges Gespräch oder senden Sie uns eine kurze Anfrage – ganz wie es Ihnen passt.