 nl
 en
 es
 fr
 it
 de
 ar
Uitdaging
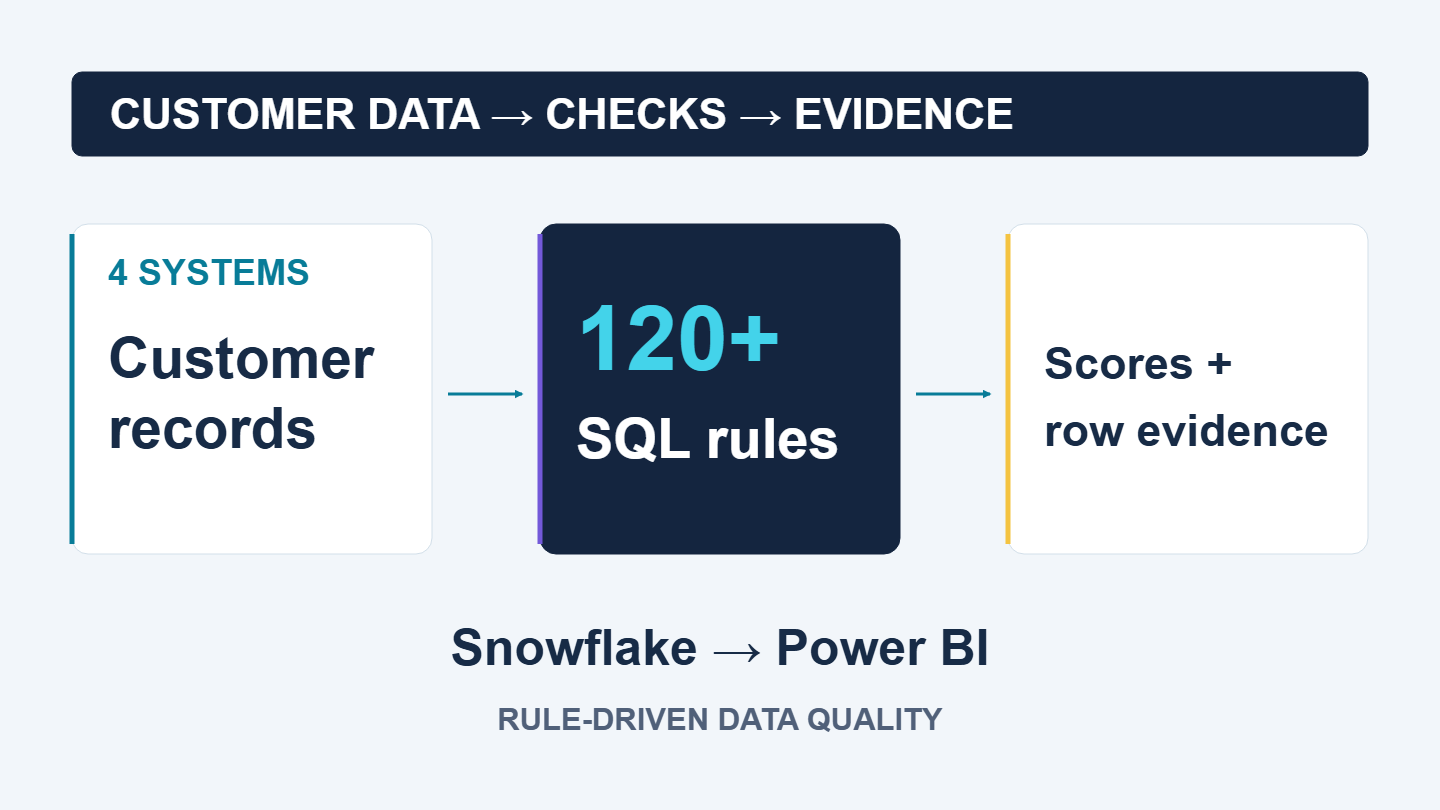
Klantdata liep uiteen tussen vier systemen, terwijl regels in rapporten fouten verhulden en scores vertekenden.

Een beheerd Snowflake-framework controleert klantdata uit vier systemen en geeft data-eigenaren scores plus bewijs op recordniveau om mee aan de slag te gaan.
Uitdaging
Klantdata liep uiteen tussen vier systemen, terwijl regels in rapporten fouten verhulden en scores vertekenden.
Geleverde oplossing
SQL-entiteitsviews, een geteste regelcatalogus, een evaluatie-engine in Snowflake en rapportage via DirectQuery.
Bedrijfswaarde
Beheerde regels, eerlijke scores en bewijs op rijniveau waarmee data-eigenaren records kunnen corrigeren.
Een bedrijf in medische voeding beheert de klantdata van zijn zorgprofessionals in vier systemen: een platform voor digitale identiteit, een CRM, een platform voor marketingautomatisering en een webshop. Elk systeem heeft zijn eigen versie van de klant, waardoor namen, e-mailadressen, adressen en toestemmingen uiteen kunnen gaan lopen.
Het bestaande datakwaliteitsrapport was organisch gegroeid. De regels stonden verspreid over rapportformules en datatransformaties, en de scores werden één keer per verversing berekend, zodat ze niet op filters reageerden. Sommige records werden eruit gefilterd voordat ze werden gemeten, waardoor de scores er beter uitzagen dan ze waren. Het rapport kon ook zeggen dat een percentage laag was, maar niet welke records fout waren of waarom.
We begonnen met reverse-engineering van het bestaande rapport: elke bron, transformatie en measure werd gedocumenteerd, en elk probleem in de logica werd op een lijst gezet. Dat gaf een duidelijke baseline en een lijst van wat moest veranderen.
Daarna bouwden we datakwaliteit opnieuw op als een framework in plaats van een rapport:
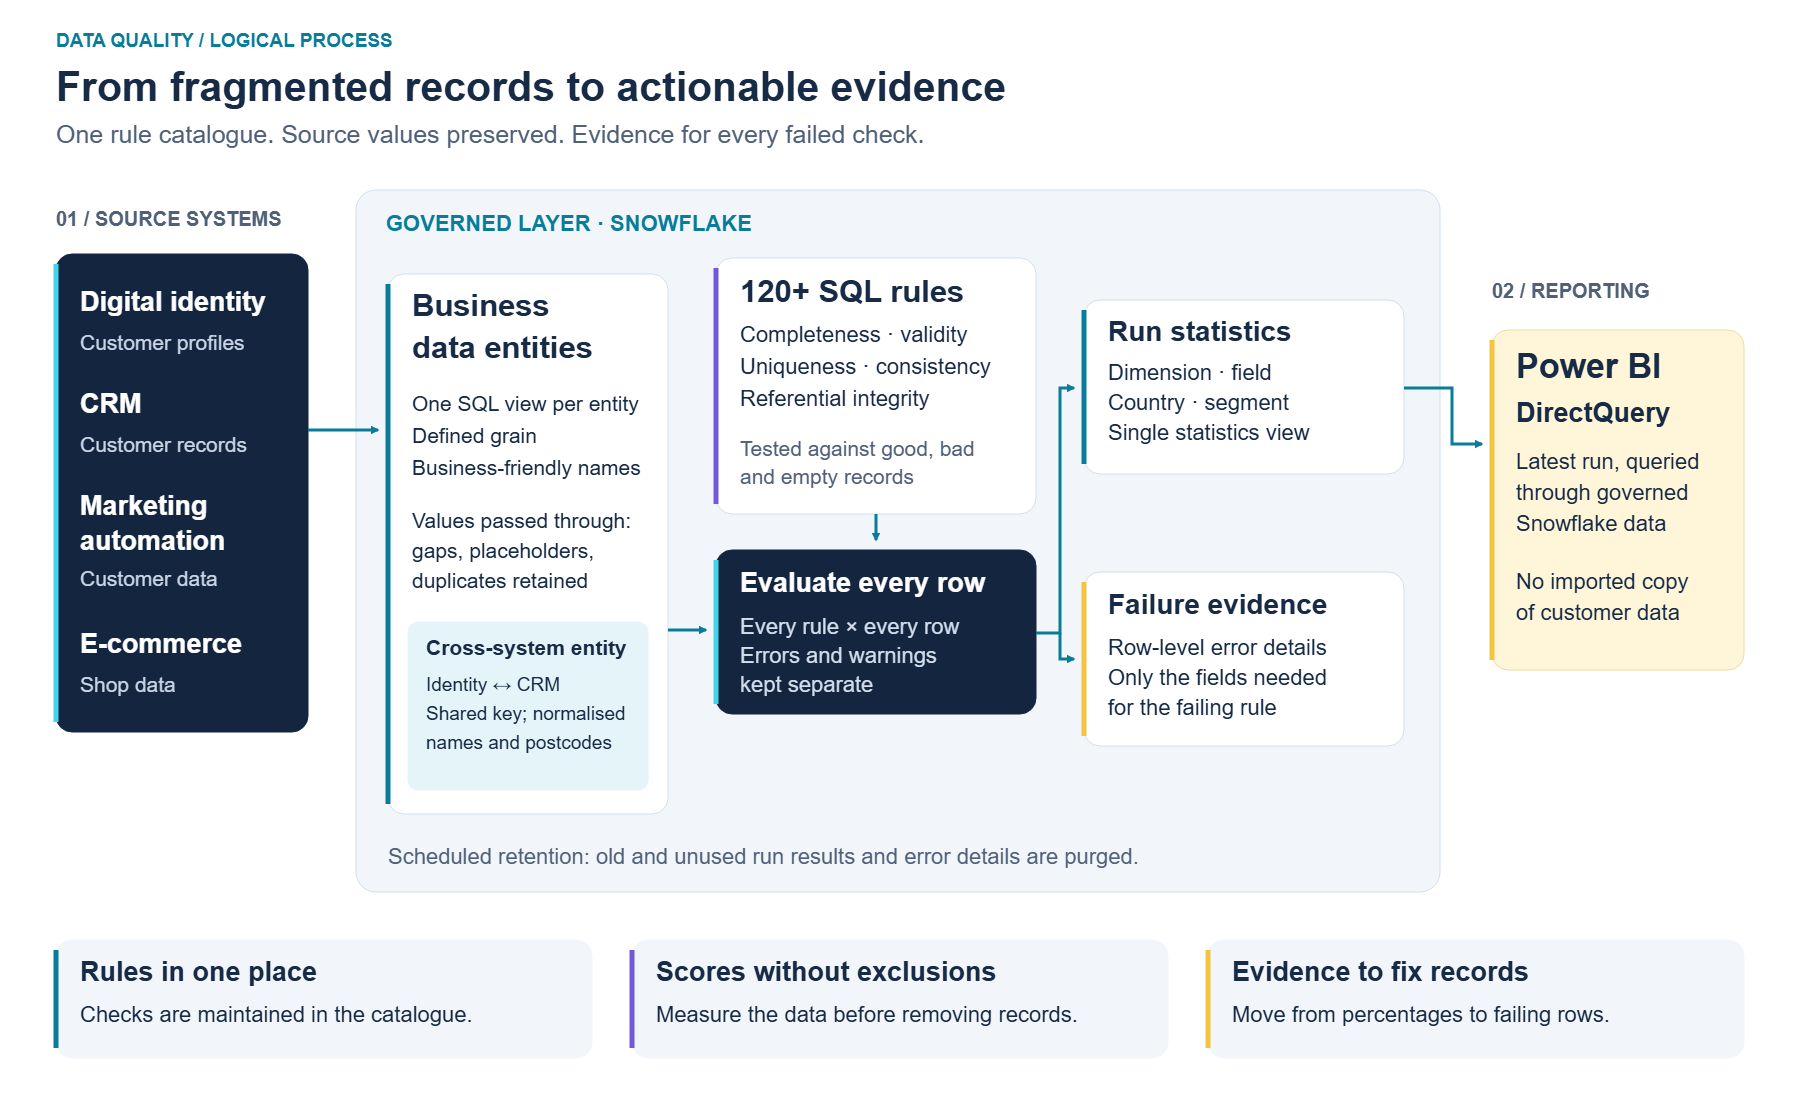
Vier bronsystemen voeden SQL-views per bedrijfsentiteit in Snowflake, zonder hiaten, placeholders of duplicaten weg te filteren. Een geteste catalogus van meer dan 120 regels stuurt de evaluatie per rij aan. De engine scheidt fouten en waarschuwingen en levert gesegmenteerde runstatistieken plus bewijs van fouten op rijniveau. Eén statistiekenview voedt Power BI via DirectQuery. Geplande retentie schoont oude en ongebruikte runresultaten en foutdetails op.
Kwalitatieve projectresultaten; er worden geen gemeten besparingen geclaimd.
Eén beheerde plek voor datakwaliteitsregels, in plaats van logica verspreid over een rapport
Eerlijke scores: er wordt niets verwijderd voordat het is gemeten
Bewijs op rijniveau voor elke fout, zodat data-eigenaren records kunnen herstellen in plaats van over percentages te discussiëren
Consistentie tussen systemen zichtbaar gemaakt: of dezelfde klant er in het identiteitsplatform en in het CRM hetzelfde uitziet
Resultaten uitgesplitst naar land en klantsegment, met correcte totalen om foutpercentages te berekenen
Nieuwe controles worden als rij aan de catalogus toegevoegd; codewijzigingen zijn niet nodig
Geen kopieën van klantdata in de rapportagetool en geen opeenstapeling van verouderde resultaten: data blijft in Snowflake en wordt alleen bewaard zolang die nodig is
Oplossingsgebieden: Datafundament · Data governance

Kies voor een gesprek van 30 minuten of stuur ons een korte aanvraag - wat u het beste past.