 de
 en
 es
 fr
 nl
 it
 ar
Ausgangslage
Kundendaten drifteten über vier Systeme auseinander, während berichtsbasierte Regeln Fehler verdeckten und Scores verzerrten.

Ein kontrolliertes Snowflake-Framework prüft Kundendaten über vier Systeme hinweg und gibt Data Ownern Scores sowie Nachweise auf Datensatzebene, mit denen sie arbeiten können.
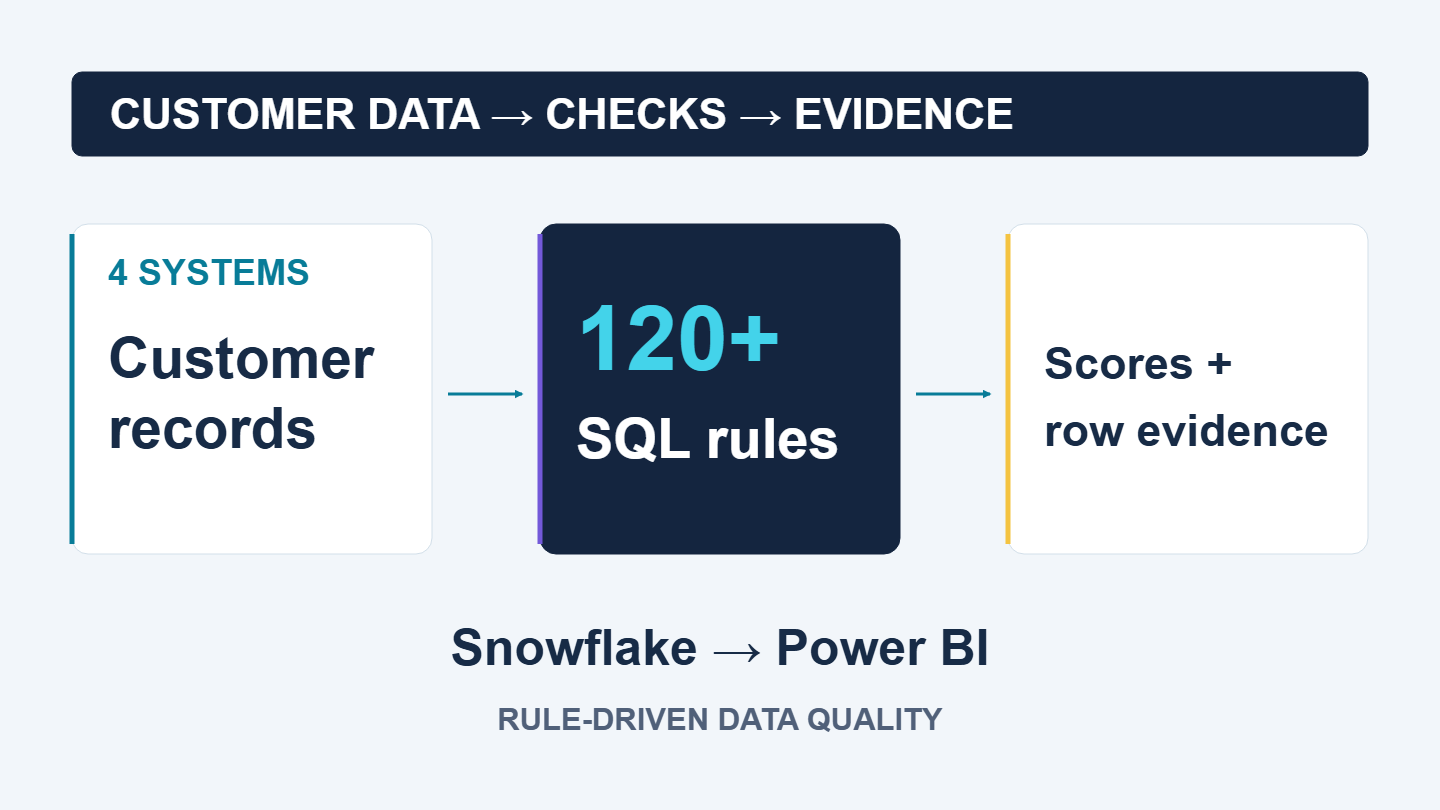
Ausgangslage
Kundendaten drifteten über vier Systeme auseinander, während berichtsbasierte Regeln Fehler verdeckten und Scores verzerrten.
Umgesetzte Lösung
SQL-Entitätssichten, ein getesteter Regelkatalog, eine Auswertungs-Engine in Snowflake und DirectQuery-Reporting.
Mehrwert
Kontrollierte Regeln, ehrliche Scores und Nachweise auf Zeilenebene, mit denen Data Owner Datensätze korrigieren können.
Ein Unternehmen für medizinische Ernährung verwaltet die Kundendaten seiner medizinischen Fachkräfte in vier Systemen: einer Plattform für digitale Identitäten, einem CRM, einer Marketing-Automation-Plattform und einem E-Commerce-Shop. Jedes System hält seine eigene Version des Kunden, sodass Namen, E-Mail-Adressen, Anschriften und Einwilligungen auseinanderlaufen können.
Der bestehende Datenqualitätsbericht war organisch gewachsen. Seine Regeln waren über Berichtsformeln und Datentransformationen verteilt, und seine Scores wurden einmal pro Aktualisierung berechnet, reagierten also nicht auf Filter. Manche Datensätze wurden herausgefiltert, bevor sie gemessen wurden – die Scores sahen dadurch besser aus, als sie waren. Der Bericht konnte zwar sagen, dass ein Prozentwert niedrig war, aber nicht, welche Datensätze falsch waren oder warum.
Wir begannen mit dem Reverse Engineering des bestehenden Berichts: Jede Quelle, jede Transformation und jede Measure wurde dokumentiert, und jedes Problem in der Logik wurde aufgelistet. Das ergab eine klare Baseline und eine Liste dessen, was sich ändern musste.
Anschließend haben wir die Datenqualität als Framework statt als Bericht neu aufgebaut:
Vier Quellsysteme speisen SQL-Sichten für Geschäftsobjekte in Snowflake, ohne Lücken, Platzhalter oder Duplikate herauszufiltern. Ein getesteter Katalog mit mehr als 120 Regeln steuert die Zeilenauswertung. Die Engine trennt Fehler und Warnungen und erzeugt segmentierte Laufstatistiken sowie Fehlernachweise auf Zeilenebene. Eine einzige Statistiksicht speist Power BI per DirectQuery. Eine geplante Aufbewahrungsroutine löscht alte und ungenutzte Laufergebnisse und Fehlerdetails.
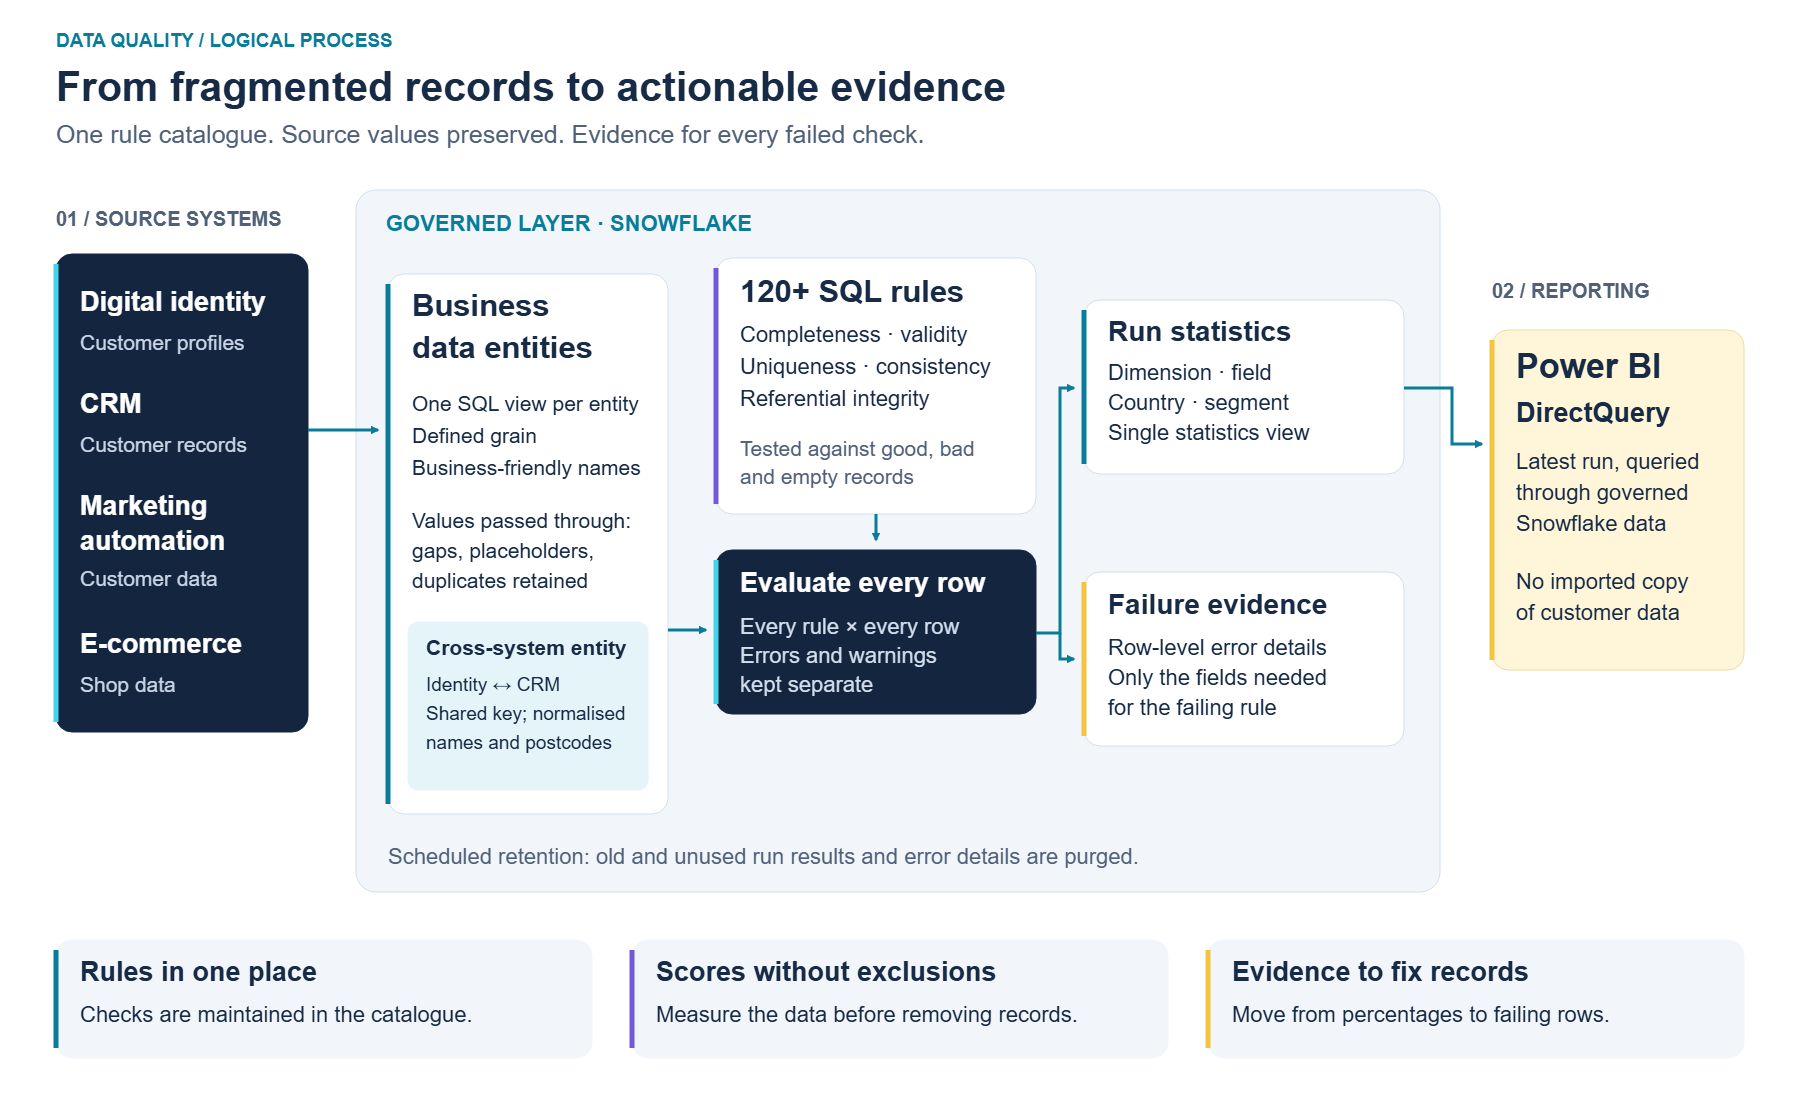
Qualitative Projektergebnisse; es werden keine gemessenen Einsparungen behauptet.
Ein kontrollierter Ort für Datenqualitätsregeln statt Logik, die über einen Bericht verteilt ist
Ehrliche Scores: Nichts wird entfernt, bevor es gemessen wird
Nachweise auf Zeilenebene für jeden Fehler, damit Data Owner Datensätze korrigieren können, statt über Prozentwerte zu diskutieren
Systemübergreifende Konsistenz sichtbar gemacht: ob derselbe Kunde in der Identitätsplattform und im CRM gleich aussieht
Ergebnisse aufgeschlüsselt nach Land und Kundensegment, mit sauberen Summen zur Berechnung von Fehlerquoten
Neue Prüfungen kommen als Zeile im Katalog hinzu; Codeänderungen sind nicht nötig
Keine Kopien von Kundendaten im Reporting-Tool und keine Ansammlung veralteter Ergebnisse: Die Daten bleiben in Snowflake und werden nur so lange aufbewahrt, wie sie gebraucht werden
Lösungsbereiche: Datenfundament · Data Governance

Wählen Sie ein 30-minütiges Gespräch oder senden Sie uns eine kurze Anfrage – ganz wie es Ihnen passt.