fr
 en
 es
 nl
 it
 de
 ar
Optimisation des données de référence
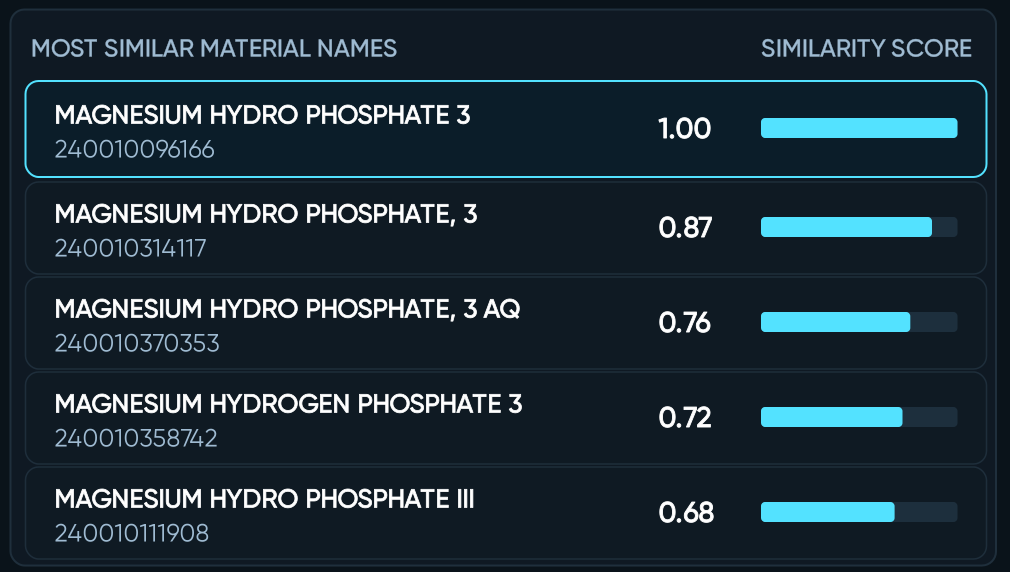
La solution d'optimisation des données de référence s'appuie sur les descriptions des articles, leurs attributs et les habitudes d'achat pour repérer les articles similaires ou en double entre sites et ERP. Son moteur de similarité regroupe les candidats, estime les opportunités de consolidation et appuie la revue des data stewards au moyen de décisions conserver, bloquer ou rendre obsolète.
- Descriptions des articles, attributs et habitudes d'achat
- Évaluation de similarité et groupes candidats
- Opportunités de consolidation estimées
- Revue steward : conserver, bloquer, obsolète
Réalisé pour un client de la grande consommation et de l'industrie, sous NDA, avec Python, un moteur de similarité IA/ML, une intégration ERP et Power BI. Les chiffres présentés dans l'étude de cas proviennent d'une démo autonome sur données synthétiques.