 es
 en
 fr
 nl
 it
 de
 ar
Reto
Los datos de GfK debían descargarse manualmente desde un sitio web con inicio de sesión federado mediante SAML.

Obtención automatizada de datos de GfK tras un inicio de sesión protegido con SAML.
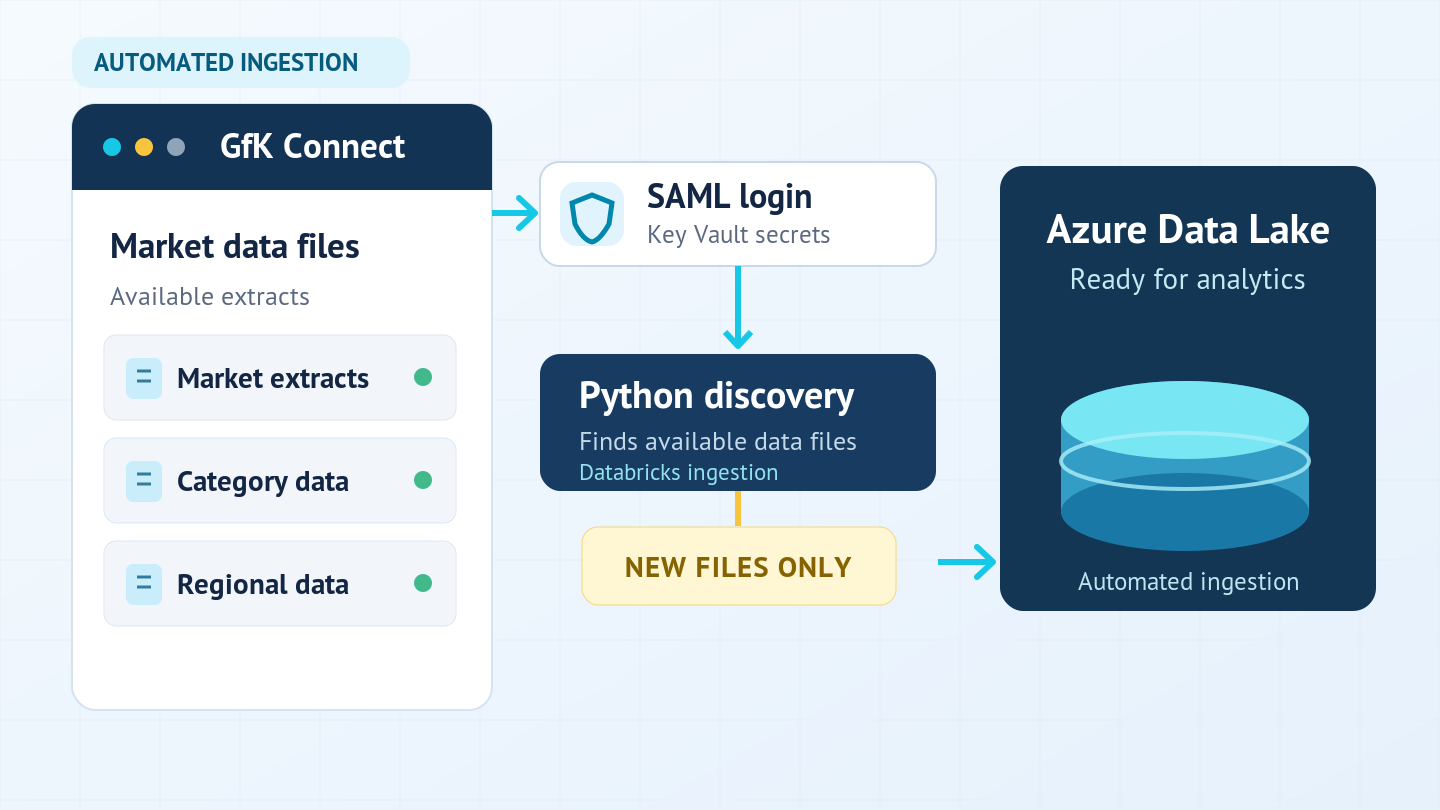
Inicio de sesión SAML con credenciales de Azure Key Vault, descubrimiento automático de archivos e ingesta con Databricks de los archivos nuevos en Azure Data Lake.
Reto
Los datos de GfK debían descargarse manualmente desde un sitio web con inicio de sesión federado mediante SAML.
Entregado
Un flujo totalmente automatizado para el inicio de sesión SAML, el descubrimiento de archivos y la ingesta.
Hizo posible
Los nuevos archivos de GfK llegan a Azure Data Lake sin pasos manuales ni secretos en el código.
GfK, una empresa líder en investigación de mercados, proporciona datos críticos sobre bienes de consumo, pero acceder a ellos exigía descargas manuales a través de un sitio web cuyo inicio de sesión estaba protegido por federación SAML. Obtener esos datos e integrarlos en una capa analítica moderna resultaba engorroso y propenso a errores, y el paso manual bloqueaba cualquier intento de automatización.
Construimos un flujo totalmente automatizado que gestiona de principio a fin el inicio de sesión SAML, el descubrimiento de archivos y la ingesta. La autenticación utiliza la biblioteca Mechanize de Python para ejecutar de forma programática el flujo de inicio de sesión de GfK Federation, con credenciales recuperadas en tiempo de ejecución desde Azure Key Vault: los secretos nunca residen en el código ni en archivos de configuración.
Una vez autenticado, el sistema utiliza BeautifulSoup para recorrer el portal GfK Connect y extraer automáticamente la lista de archivos de datos disponibles, lo que elimina la búsqueda manual. A continuación, un clúster de cómputo de Databricks orquesta la ingesta: descarta los archivos ya procesados y transfiere solo los datos nuevos a Azure Data Lake, de forma eficiente, escalable e idempotente.
Mechanize de Python ejecuta el flujo de inicio de sesión de GfK Federation, con credenciales recuperadas en tiempo de ejecución desde Azure Key Vault.
BeautifulSoup recorre el portal GfK Connect y extrae la lista de archivos de datos disponibles.
Un clúster de cómputo de Databricks descarta los archivos ya procesados y transfiere solo los datos nuevos a Azure Data Lake.
Resultados cualitativos del proyecto; no se afirma ningún ahorro medido.
Obtención de datos totalmente automatizada y segura, que elimina el paso de descarga manual
Integración fluida con el almacenamiento en la nube de Azure y con el procesamiento posterior
Mayor seguridad: credenciales gestionadas con Azure Key Vault, nunca en el código fuente
Arquitectura escalable que se adapta a volúmenes de datos crecientes y a nuevos feeds de GfK
Patrón reproducible y reutilizable para cualquier fuente de datos protegida con SAML
Áreas de solución: Fundamentos de datos

Elija una conversación de 30 minutos o envíenos una breve consulta, lo que le resulte más cómodo.