 nl
 en
 es
 fr
 it
 de
 ar
Uitdaging
GfK-data moest handmatig worden gedownload van een website met een SAML-gefedereerde login.

Geautomatiseerd ophalen van GfK-data achter een met SAML beveiligde login.
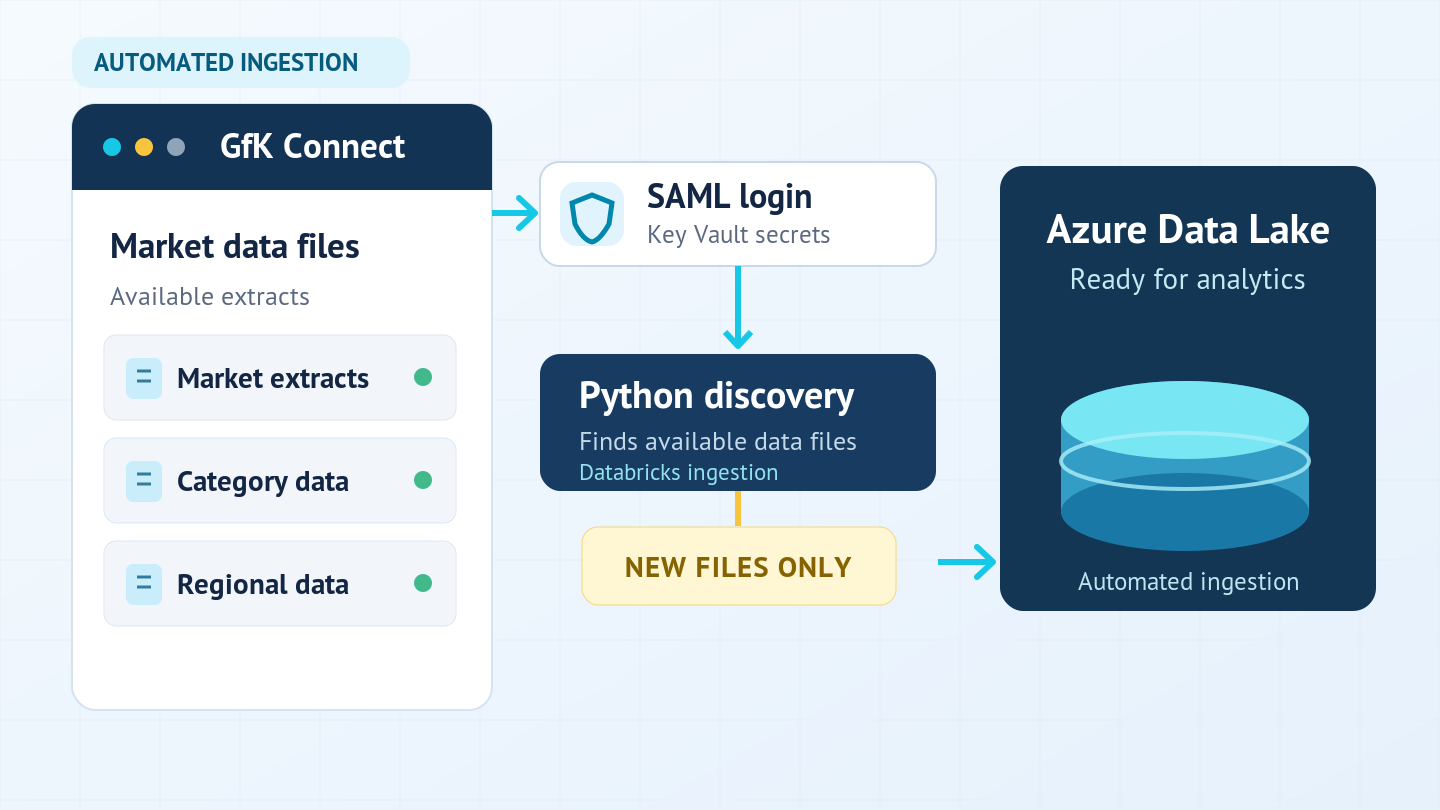
SAML-login met credentials uit Azure Key Vault, automatische bestandsdetectie en ingestie van nieuwe bestanden in Azure Data Lake via Databricks.
Uitdaging
GfK-data moest handmatig worden gedownload van een website met een SAML-gefedereerde login.
Opgeleverd
Een volledig geautomatiseerde workflow voor SAML-login, bestandsdetectie en ingestie.
Effect
Nieuwe GfK-bestanden komen in Azure Data Lake terecht zonder handmatige stappen of secrets in code.
GfK, een toonaangevend marktonderzoeksbureau, levert essentiële data over consumentengoederen - maar de toegang vroeg om handmatige downloads via een website, met een loginflow die door SAML-federatie is beveiligd. Die data ophalen en integreren in een moderne analyticslaag was omslachtig en foutgevoelig, en de handmatige stap blokkeerde elke poging tot automatisering.
We bouwden een volledig geautomatiseerde workflow die SAML-login, bestandsdetectie en ingestie end-to-end afhandelt. Voor de authenticatie stuurt de Mechanize-library van Python de loginflow van GfK Federation programmatisch aan, met credentials die tijdens runtime uit Azure Key Vault worden opgehaald - secrets staan nooit in code of configuratiebestanden.
Na authenticatie scant het systeem met BeautifulSoup het GfK Connect-portaal en haalt het automatisch de lijst met beschikbare databestanden op, zodat handmatig zoeken niet meer nodig is. Een Databricks Compute Cluster orkestreert vervolgens de ingestie: het filtert al verwerkte bestanden eruit en zet alleen nieuwe data over naar de Azure Data Lake - efficiënt, schaalbaar en idempotent.
Mechanize van Python stuurt de loginflow van GfK Federation aan, met credentials die tijdens runtime uit Azure Key Vault worden opgehaald.
BeautifulSoup scant het GfK Connect-portaal en haalt de lijst met beschikbare databestanden op.
Een Databricks Compute Cluster filtert al verwerkte bestanden eruit en zet alleen nieuwe data over naar Azure Data Lake.
Kwalitatieve projectresultaten; er worden geen gemeten besparingen geclaimd.
Volledig geautomatiseerd en veilig ophalen van data, zonder handmatige downloadstap
Naadloze integratie met Azure-cloudopslag en verdere verwerking
Betere beveiliging: credentials beheerd via Azure Key Vault, nooit in de broncode
Schaalbare architectuur die meegroeit met toenemende datavolumes en extra GfK-feeds
Reproduceerbaar patroon, herbruikbaar voor elke met SAML beveiligde databron
Oplossingsgebieden: Datafundament

Kies voor een gesprek van 30 minuten of stuur ons een korte aanvraag - wat u het beste past.