 fr
 en
 es
 nl
 it
 de
 ar
Défi
Les données GfK devaient être téléchargées à la main sur un site web à connexion fédérée SAML.

Une récupération automatisée des données GfK derrière une connexion protégée par SAML.
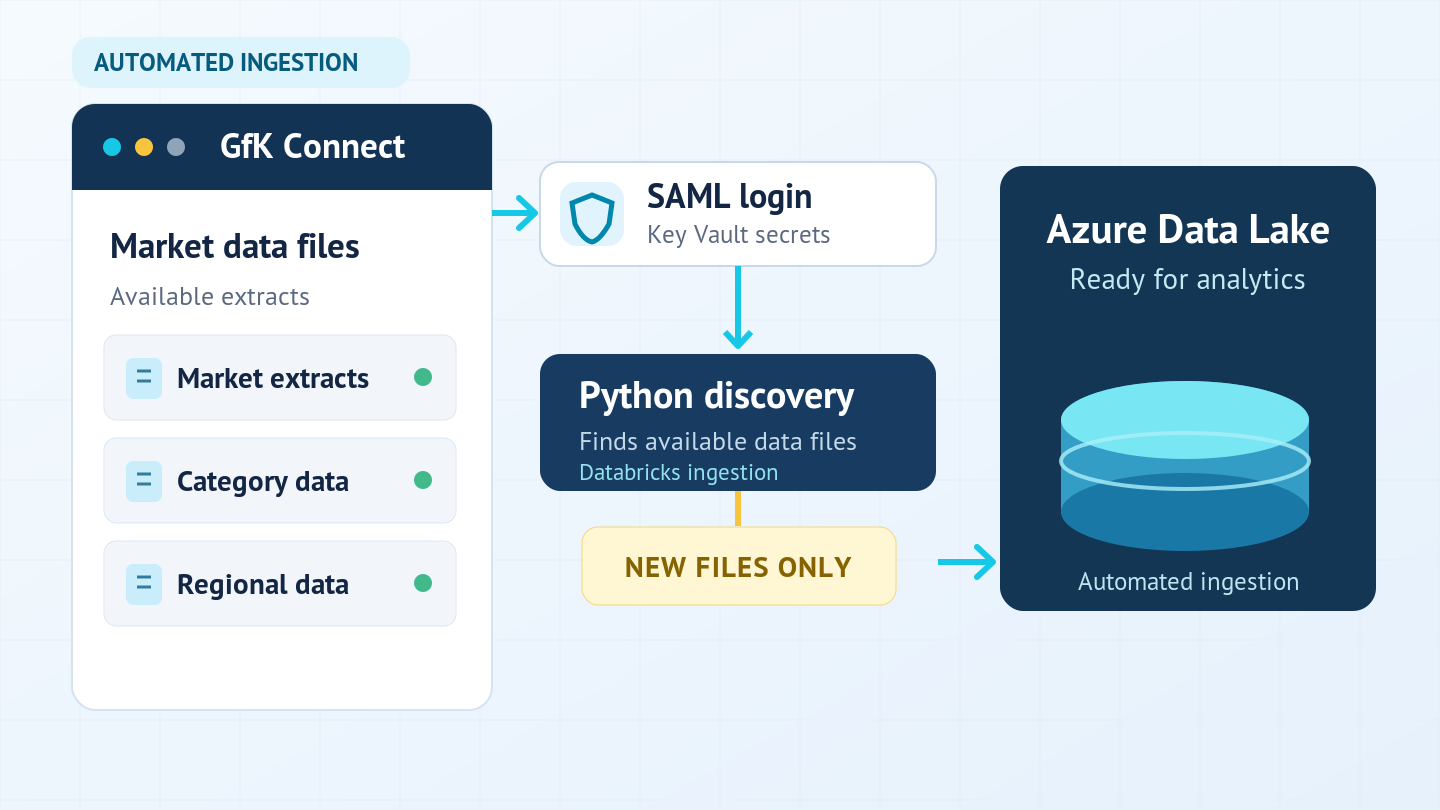
Connexion SAML avec des identifiants issus d'Azure Key Vault, découverte automatique des fichiers et ingestion des nouveaux fichiers par Databricks dans Azure Data Lake.
Défi
Les données GfK devaient être téléchargées à la main sur un site web à connexion fédérée SAML.
Livré
Un workflow entièrement automatisé pour la connexion SAML, la découverte des fichiers et l'ingestion.
Gains
Les nouveaux fichiers GfK arrivent dans Azure Data Lake sans étape manuelle ni secret dans le code.
GfK, grand institut d'études de marché, fournit des données essentielles sur les biens de consommation, mais y accéder exigeait des téléchargements manuels sur un site web, dont le parcours de connexion était protégé par une fédération SAML. Récupérer ces données et les intégrer à une couche analytique moderne était fastidieux et source d'erreurs, et l'étape manuelle bloquait toute tentative d'automatisation.
Nous avons construit un workflow entièrement automatisé qui gère de bout en bout la connexion SAML, la découverte des fichiers et l'ingestion. L'authentification s'appuie sur la bibliothèque Python Mechanize pour piloter par programme le parcours de connexion GfK Federation, avec des identifiants récupérés à l'exécution dans Azure Key Vault : les secrets ne figurent jamais dans le code ni dans les fichiers de configuration.
Une fois authentifié, le système utilise BeautifulSoup pour parcourir le portail GfK Connect et extraire automatiquement la liste des fichiers de données disponibles, ce qui supprime toute recherche manuelle. Un cluster de calcul Databricks orchestre ensuite l'ingestion : il écarte les fichiers déjà traités et ne transfère que les nouvelles données vers Azure Data Lake. Un fonctionnement efficace, évolutif et idempotent.
La bibliothèque Python Mechanize pilote le parcours de connexion GfK Federation, avec des identifiants récupérés à l'exécution dans Azure Key Vault.
BeautifulSoup parcourt le portail GfK Connect et extrait la liste des fichiers de données disponibles.
Un cluster de calcul Databricks écarte les fichiers déjà traités et ne transfère que les nouvelles données vers Azure Data Lake.
Résultats qualitatifs du projet ; aucune économie mesurée n'est avancée.
Une récupération des données entièrement automatisée et sécurisée, sans étape de téléchargement manuel
Une intégration fluide avec le stockage cloud Azure et les traitements en aval
Une sécurité renforcée : des identifiants gérés dans Azure Key Vault, jamais dans le code source
Une architecture évolutive, qui s'adapte à la croissance des volumes de données et à de nouveaux flux GfK
Un modèle reproductible, réutilisable pour toute source de données protégée par SAML
Solutions : Fondations de données

Choisissez un échange de 30 minutes ou envoyez-nous une courte demande, selon ce qui vous convient.