 it
 en
 es
 fr
 nl
 de
 ar
Sfida
I dati GfK dovevano essere scaricati manualmente da un sito web con login federato SAML.

Recupero automatizzato dei dati GfK dietro un login protetto da SAML.
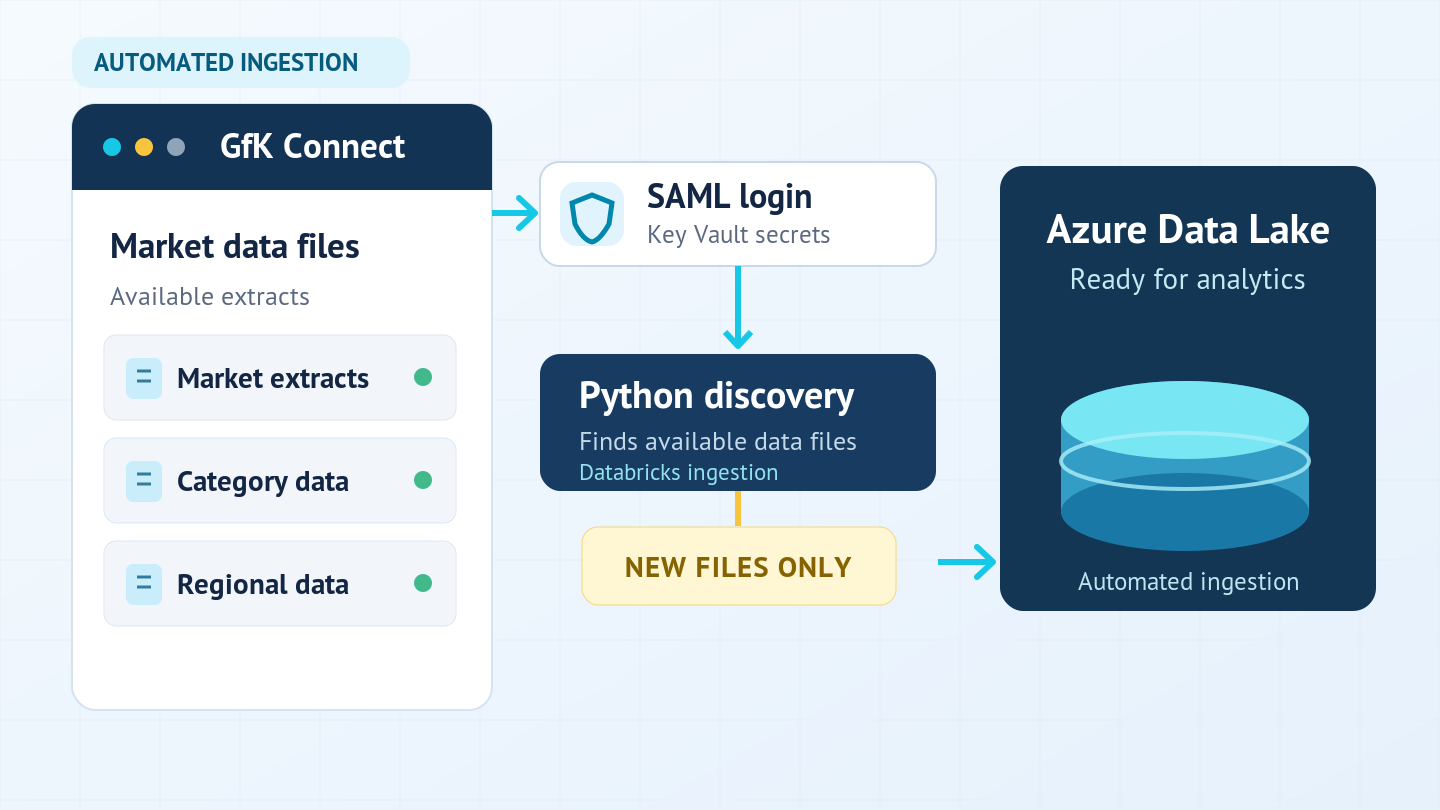
Login SAML con credenziali da Azure Key Vault, discovery automatica dei file e ingestion dei nuovi file in Azure Data Lake con Databricks.
Sfida
I dati GfK dovevano essere scaricati manualmente da un sito web con login federato SAML.
Realizzato
Un flusso completamente automatizzato per login SAML, discovery dei file e ingestion.
Ottenuto
I nuovi file GfK arrivano in Azure Data Lake senza passaggi manuali né secret nel codice.
GfK, tra le principali società di ricerche di mercato, fornisce dati fondamentali sui beni di consumo, ma per accedervi occorrevano download manuali da un sito web, con un flusso di login protetto da federazione SAML. Reperire questi dati e integrarli in un moderno layer di analytics era macchinoso e soggetto a errori, e il passaggio manuale bloccava ogni tentativo di automazione.
Abbiamo costruito un flusso completamente automatizzato che gestisce end-to-end login SAML, discovery dei file e ingestion. L'autenticazione usa la libreria Python Mechanize per eseguire in modo programmatico il flusso di login della GfK Federation, con credenziali recuperate a runtime da Azure Key Vault: i secret non risiedono mai nel codice o nei file di configurazione.
Dopo l'autenticazione, il sistema usa BeautifulSoup per analizzare il portale GfK Connect ed estrarre automaticamente l'elenco dei file di dati disponibili, eliminando la ricerca manuale. Un Databricks Compute Cluster orchestra poi l'ingestion: esclude i file già elaborati e trasferisce solo i nuovi dati in Azure Data Lake, in modo efficiente, scalabile e idempotente.
Mechanize di Python esegue il flusso di login della GfK Federation, con credenziali recuperate a runtime da Azure Key Vault.
BeautifulSoup analizza il portale GfK Connect ed estrae l'elenco dei file di dati disponibili.
Un Databricks Compute Cluster esclude i file già elaborati e trasferisce solo i nuovi dati in Azure Data Lake.
Risultati qualitativi di progetto; non si dichiarano risparmi misurati.
Recupero dei dati completamente automatizzato e sicuro, senza più download manuali
Integrazione fluida con lo storage cloud Azure e con l'elaborazione a valle
Maggiore sicurezza: credenziali gestite tramite Azure Key Vault, mai nel codice sorgente
Architettura scalabile che si adatta a volumi di dati crescenti e a ulteriori feed GfK
Pattern riproducibile e riutilizzabile per qualsiasi fonte di dati protetta da SAML
Aree di soluzione: Fondamenta dei dati

Scegliete una conversazione di 30 minuti o inviateci una breve richiesta: come preferite.