 de
 en
 es
 fr
 nl
 it
 ar
Ausgangslage
GfK-Daten mussten manuell von einer Website mit SAML-föderiertem Login heruntergeladen werden.

Automatisierter Abruf von GfK-Daten hinter einem SAML-geschützten Login.
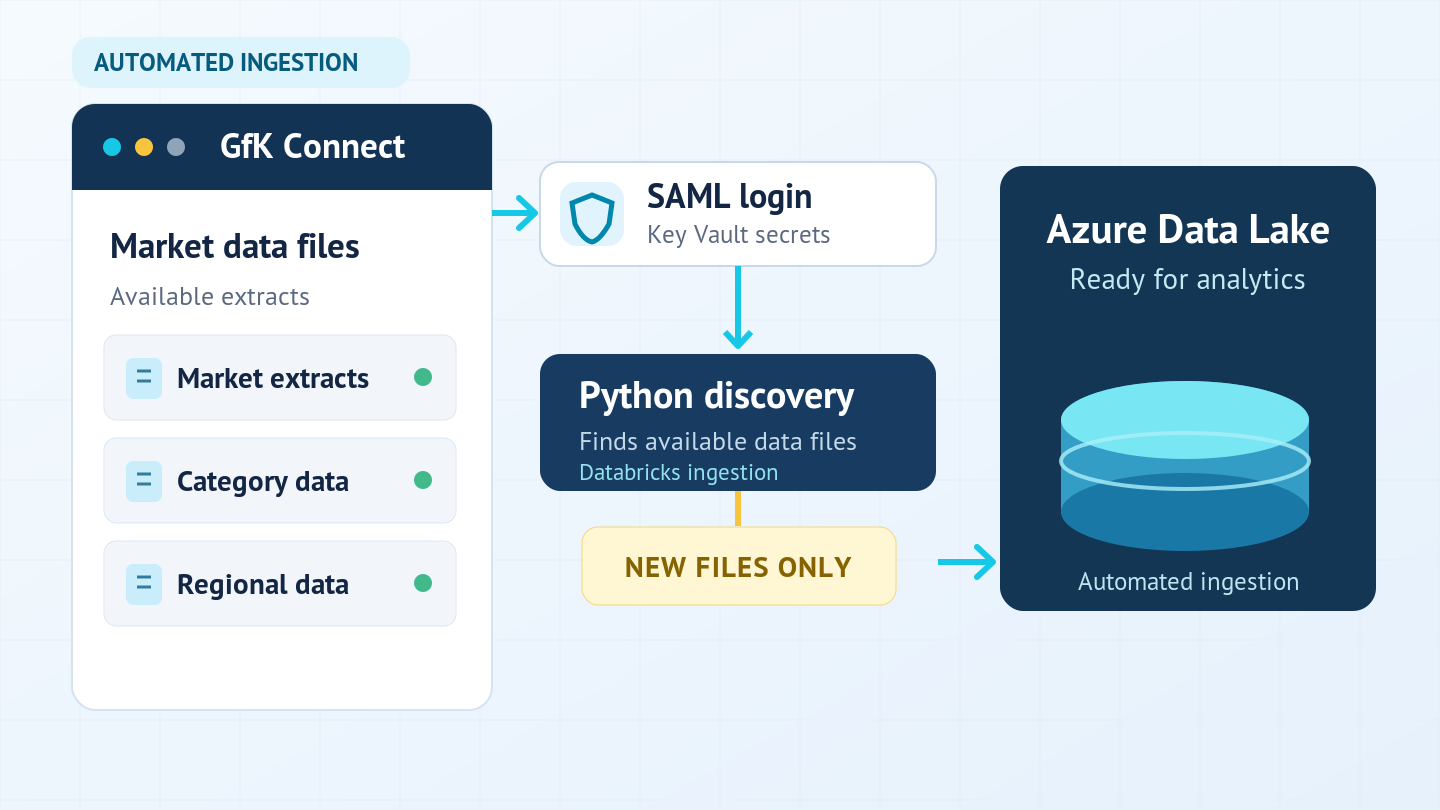
SAML-Login mit Zugangsdaten aus Azure Key Vault, automatische Dateierkennung und Databricks-Ingestion neuer Dateien in den Azure Data Lake.
Ausgangslage
GfK-Daten mussten manuell von einer Website mit SAML-föderiertem Login heruntergeladen werden.
Umgesetzt
Ein vollständig automatisierter Workflow für SAML-Login, Dateierkennung und Ingestion.
Wirkung
Neue GfK-Dateien landen ohne manuelle Schritte und ohne Secrets im Code im Azure Data Lake.
GfK, ein führendes Marktforschungsunternehmen, liefert wichtige Konsumgüterdaten – der Zugriff erforderte jedoch manuelle Downloads über eine Website, deren Login-Ablauf per SAML-Föderation geschützt ist. Diese Daten zu beschaffen und in eine moderne Analytics-Schicht zu integrieren, war umständlich und fehleranfällig, und der manuelle Schritt blockierte jeden Automatisierungsversuch.
Wir haben einen vollständig automatisierten Workflow gebaut, der SAML-Login, Dateierkennung und Ingestion durchgängig abdeckt. Für die Authentifizierung steuert die Python-Bibliothek Mechanize den Login-Ablauf der GfK Federation programmatisch; die Zugangsdaten werden zur Laufzeit aus Azure Key Vault abgerufen – Secrets liegen nie in Code oder Konfigurationsdateien.
Nach der Authentifizierung durchsucht das System mit BeautifulSoup das Portal GfK Connect und extrahiert die Liste der verfügbaren Datendateien automatisch – die manuelle Suche entfällt. Ein Databricks Compute Cluster orchestriert anschließend die Ingestion: Er filtert bereits verarbeitete Dateien heraus und überträgt nur neue Daten in den Azure Data Lake – effizient, skalierbar und idempotent.
Mechanize (Python) steuert den Login-Ablauf der GfK Federation; die Zugangsdaten werden zur Laufzeit aus Azure Key Vault abgerufen.
BeautifulSoup durchsucht das Portal GfK Connect und extrahiert die Liste der verfügbaren Datendateien.
Ein Databricks Compute Cluster filtert bereits verarbeitete Dateien heraus und überträgt nur neue Daten in den Azure Data Lake.
Qualitative Projektergebnisse; es werden keine gemessenen Einsparungen behauptet.
Vollständig automatisierter und sicherer Datenabruf – der manuelle Download-Schritt entfällt
Nahtlose Integration mit Azure-Cloud-Speicher und nachgelagerter Verarbeitung
Mehr Sicherheit: Zugangsdaten werden über Azure Key Vault verwaltet, nie im Quellcode
Skalierbare Architektur, die mit wachsenden Datenmengen und zusätzlichen GfK-Feeds mitwächst
Reproduzierbares Muster, wiederverwendbar für jede SAML-geschützte Datenquelle
Lösungsbereiche: Datenfundament

Wählen Sie ein 30-minütiges Gespräch oder senden Sie uns eine kurze Anfrage – ganz wie es Ihnen passt.